
Le toolkit minimal d’un ingénieur IA en 2026 tient en trois blocs : orchestration, MCP et inférence locale. Je garde ça volontairement court, parce que la vraie difficulté n’est plus d’empiler des outils, c’est de construire des systèmes autonomes fiables, gouvernés et capables de tourner en production.
Pourquoi le toolkit IA devient plus léger ?
Le toolkit IA devient plus léger parce que les modèles de fondation prennent déjà en charge une partie du raisonnement, de la gestion d’état et des interactions multi-tours. C’est un changement très concret. Avant, on compensait les limites du modèle avec une pile énorme autour de lui. Maintenant, une partie de cette complexité est absorbée directement par le modèle.
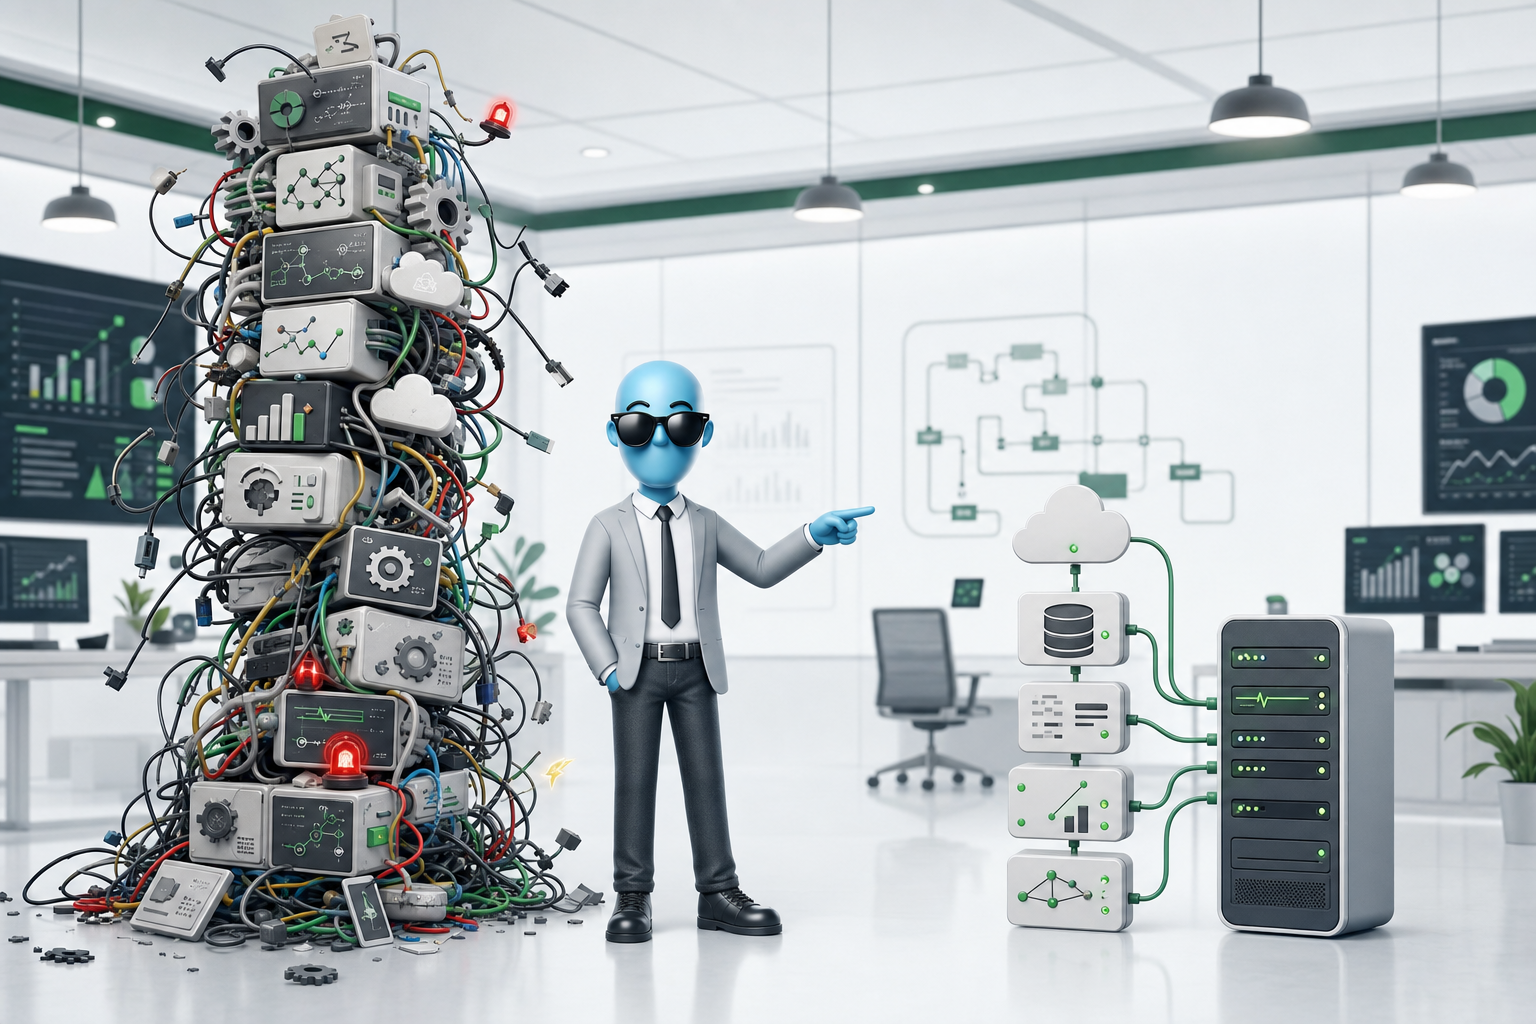
J’ai vu passer beaucoup de stacks GenAI façon kitchen sink, le fameux “on met tout dedans au cas où”. Une couche pour la mémoire. Une autre pour le routage. Un framework agentique. Des chaînes. Des wrappers. Trois formats de prompts. Une base vectorielle pour chaque sujet. Et au bout d’un moment, personne ne sait vraiment pourquoi la réponse sort comme ça.
En 2026, je préfère une approche beaucoup plus sobre. Je choisis quelques primitives solides, puis je les rends fiables. Une primitive, c’est une brique de base simple et stable. Par exemple : appeler un modèle, garder un état, interroger un outil, récupérer un document, tracer une décision. Pas besoin d’empiler quinze abstractions si quatre briques bien maîtrisées font le job.
Pour moi, un bon ingénieur IA ne cherche pas à avoir la stack la plus spectaculaire. Il cherche à maîtriser les points qui cassent vraiment en production :
- Le raisonnement : Comprendre ce que le modèle décide, et pourquoi il le décide.
- L’état : Savoir ce qui est conservé entre deux échanges, et ce qui ne l’est pas.
- Les erreurs : Prévoir les sorties invalides, les hallucinations, les timeouts, les appels ratés.
- Les connexions aux outils : Encadrer ce que l’IA peut faire dans vos systèmes métiers.
- Le mode d’exécution : Définir si ça tourne en synchrone, en batch, en file d’attente, ou avec validation humaine.
Moins il y a de composants inutiles, plus c’est facile à tester, auditer, sécuriser et maintenir. C’est bête, mais c’est souvent là que se joue la différence entre une démo impressionnante et un système qui tient six mois en production.
Observation honnête du terrain : beaucoup de projets IA échouent moins à cause du modèle qu’à cause d’une architecture trop compliquée. Quand l’agent part dans une mauvaise direction et qu’il faut ouvrir huit couches de logs pour comprendre, l’équipe perd vite confiance. Et souvent, elle a raison.
| Ancienne approche | Empiler des composants pour chaque problème : mémoire, agents, chaînes, routage, wrappers, bases vectorielles partout. |
| Nouvelle approche | Choisir quelques primitives solides, bien observées, bien testées, avec des responsabilités claires. |
| Bénéfice concret | Moins de bugs invisibles, moins de dette technique, plus de sécurité, et une production plus facile à maintenir. |
Comment orchestrer un agent IA ?
On orchestre un agent IA en contrôlant son raisonnement, son état et ses erreurs avec des graphes de code ou des boucles d’événements. L’orchestration, c’est le cœur du système. C’est elle qui décide ce qui se passe quand le modèle hésite, se trompe, attend un outil, reprend une conversation ou doit relancer une tâche.
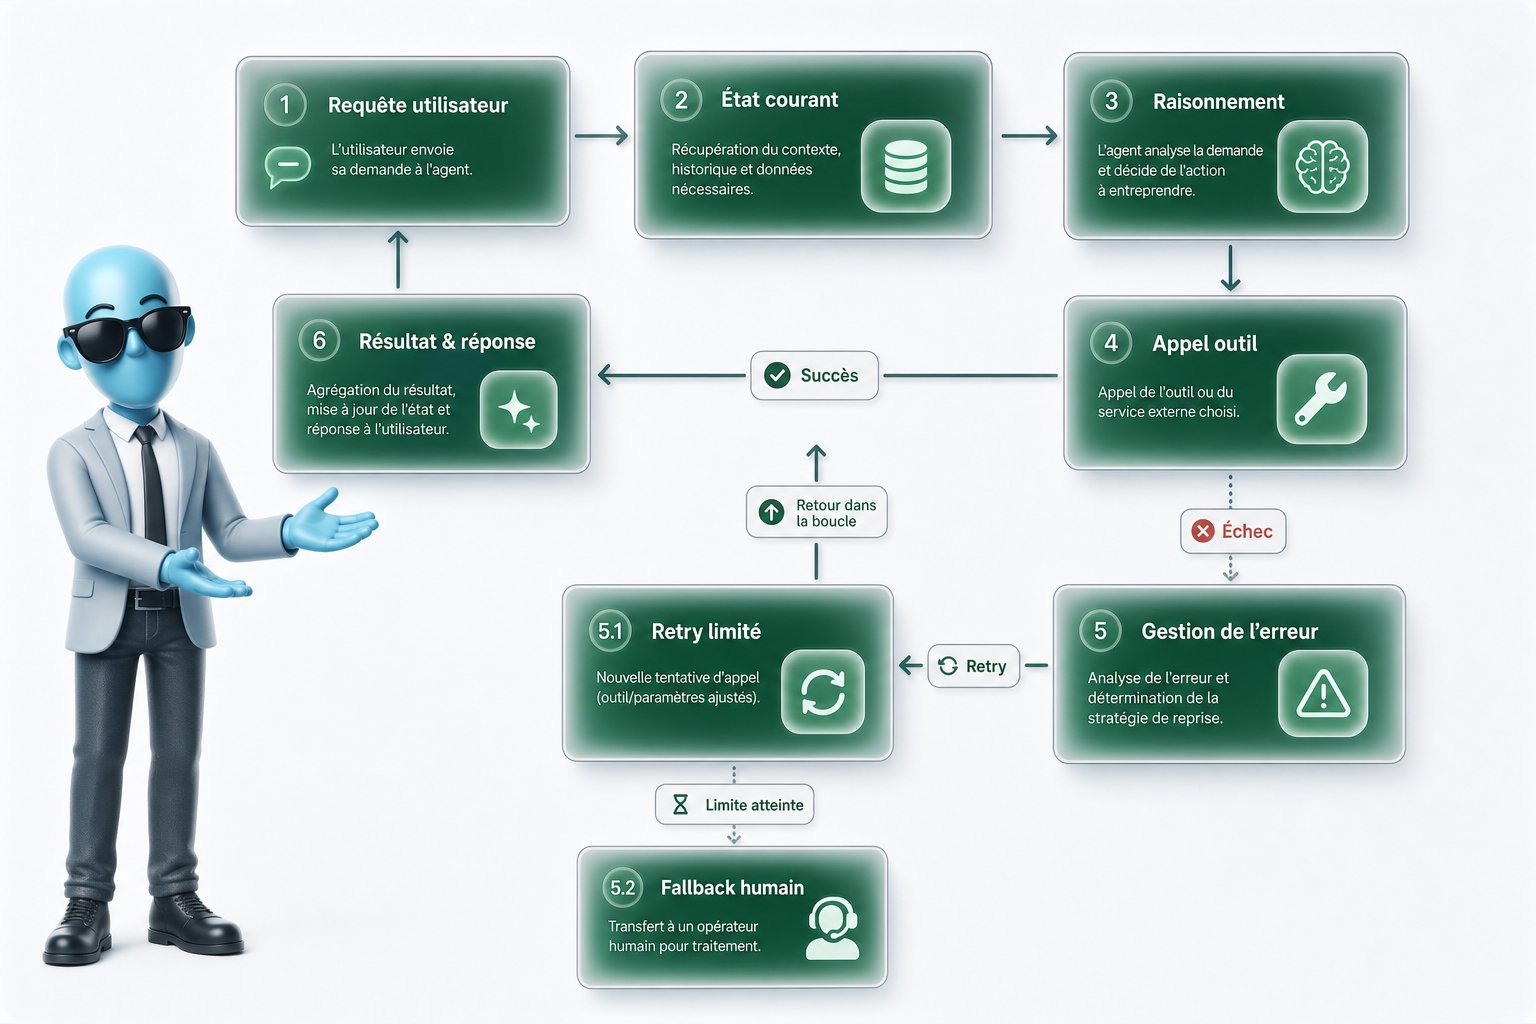
Je le vois souvent chez les clients : le problème n’est pas que le modèle “ne sait pas”. Le problème, c’est qu’on ne sait pas toujours ce qu’il va faire ensuite. L’orchestration ne rend pas l’agent plus intelligent. Elle rend son comportement contrôlable.
Il y a deux grandes familles.
- Les graphes de code sont adaptés aux systèmes complexes, avec mémoire multi-tours, décisions conditionnelles, validations métier et chemins d’exécution qu’on veut tester précisément.
- L’orchestration visuelle marche mieux pour les workflows asynchrones, déclenchés par événements, avec des connecteurs business et des automatisations lisibles par des équipes pas uniquement dev.
Concrètement, on orchestre pour faire des choses simples mais vitales : relancer un outil qui échoue, basculer vers un humain, mémoriser une étape validée, arrêter proprement si une condition business n’est pas remplie.
Voici une mini boucle Python. Elle montre l’idée production sans dépendance lourde : un état, un raisonnement simulé, un appel outil, une erreur, un retry limité.
state = {
    "user_request": "Analyse ce dossier client",
    "step": "start",
    "tool_result": None,
    "errors": [],
    "retries": 0,
    "max_retries": 2
}

def reason(state):
    # Simule la décision de l'agent à partir de l'état courant.
    if state["tool_result"] is None:
        return "call_tool"
    return "finish"

def call_tool():
    # Simule un outil externe qui peut échouer.
    raise TimeoutError("L'outil ne répond pas")

while state["step"] != "done":
    action = reason(state)

    if action == "call_tool":
        try:
            state["tool_result"] = call_tool()
            state["step"] = "tool_validated"
        except Exception as error:
            state["errors"].append(str(error))
            state["retries"] += 1

            if state["retries"] > state["max_retries"]:
                state["step"] = "human_fallback"
                break

    if action == "finish":
        state["step"] = "done"

print(state)
En orchestration visuelle, je raisonnerais autrement. Un événement entrant déclenche le workflow. Une validation vérifie les données. L’agent analyse la demande. Un outil récupère ou écrit une information. Une notification part vers la bonne personne. Un log garde la trace de chaque étape. C’est moins fin qu’un graphe de code, mais beaucoup plus lisible pour faire tourner des opérations business.
| Approche | Usage | Avantage | Limite |
| Graphes de code | Systèmes complexes, mémoire, conditions, tests précis | Contrôle fin et logique robuste | Demande plus de compétences dev |
| Orchestration visuelle | Workflows événementiels, connecteurs, automatisations métier | Lisible, rapide à modifier, accessible aux équipes | Moins adaptée aux raisonnements très complexes |
À quoi sert MCP dans une stack IA ?
MCP sert à connecter les agents IA aux données et aux outils avec un standard commun, au lieu d’écrire des wrappers sur mesure pour chaque intégration. Un agent ne vaut pas grand-chose s’il ne peut pas lire une base, chercher dans un CRM, déclencher une action, modifier un ticket ou interagir avec les systèmes qui font tourner le business.
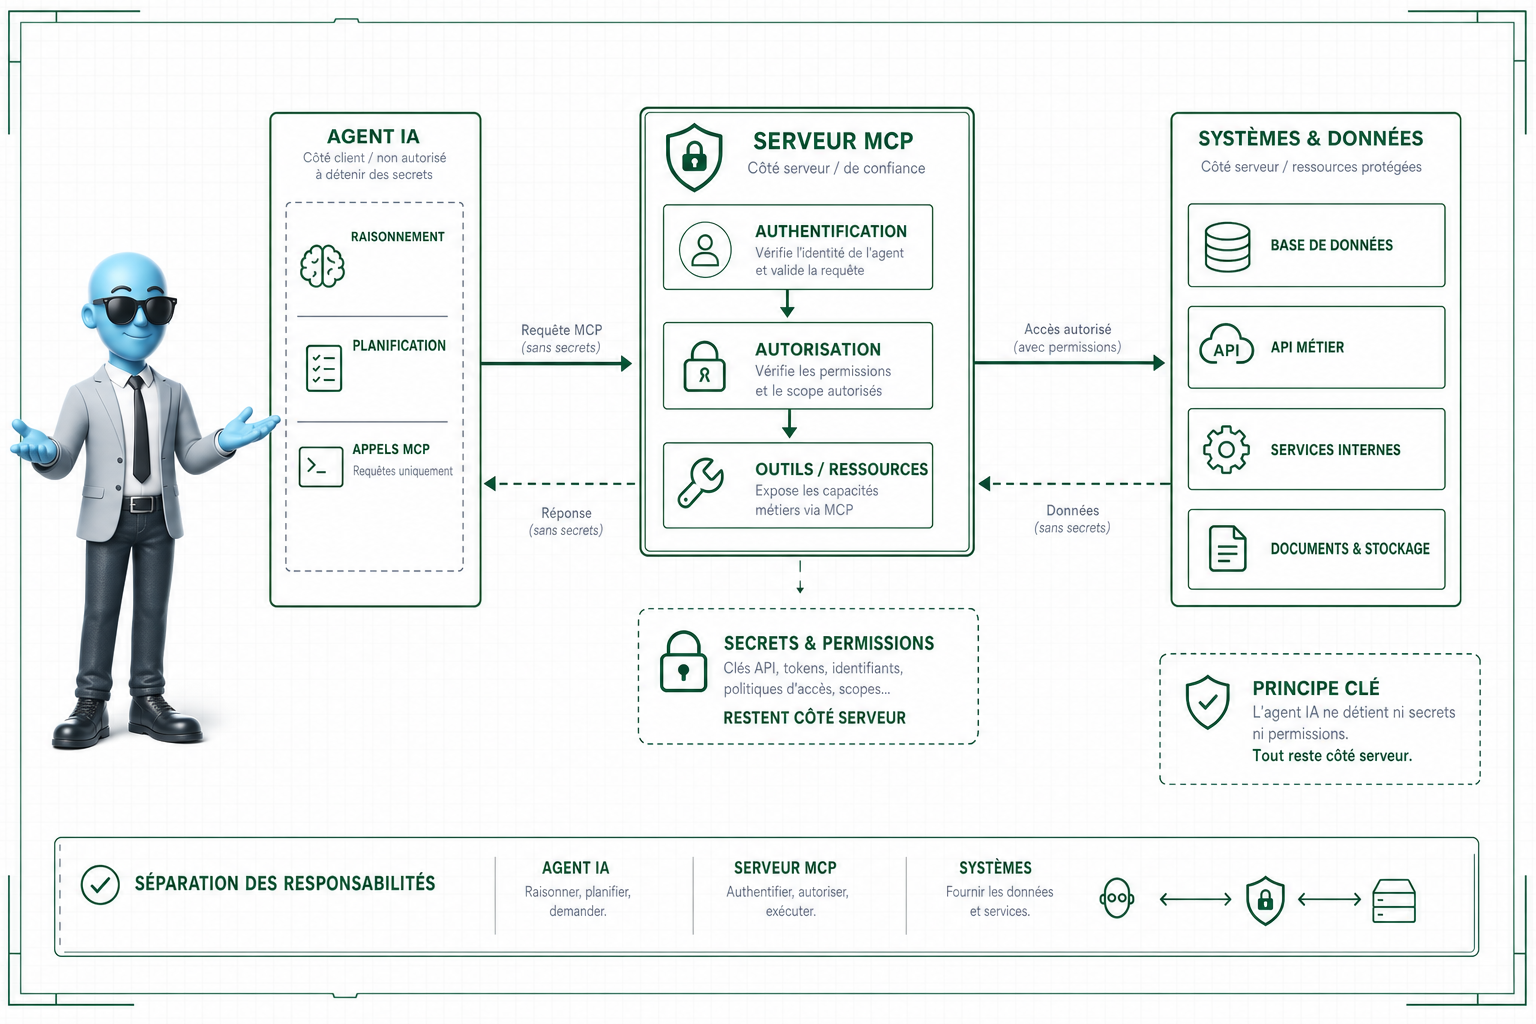
Je vois MCP comme une primitive de connexion entre agents, outils et données. Le protocole standardise l’accès aux capacités exposées côté serveur. Dit simplement, l’agent ne parle pas directement à Salesforce, Postgres, Notion ou votre backend interne. Il demande à un serveur d’outils ce qu’il peut faire, puis il appelle une capacité autorisée.
C’est là que ça devient intéressant. La complexité ne disparaît pas. Elle se déplace. Avant, on bricolait des wrappers dans tous les sens, avec des contrats d’intégration fragiles. Avec MCP, le vrai sujet devient la gouvernance : droits, identifiants, secrets, scopes d’accès, règles métier côté serveur. Et franchement, en production, c’est une bonne chose. Les accès doivent être centralisés, traçables et contrôlables.
Voici un exemple volontairement simplifié. Ce n’est pas une implémentation complète de la spécification MCP. Ça montre juste la séparation entre l’agent, le serveur d’outils, l’authentification et l’exécution.
// Serveur d'outils côté backend.
// L'agent ne possède pas les secrets et ne parle pas directement aux systèmes internes.

const toolsServer = {
  async authenticate(request) {
    // Vérifie le token, récupère l'utilisateur et ses droits.
    return {
      userId: "user_123",
      scopes: ["data:search", "action:trigger"]
    };
  },

  async searchData(input, context) {
    // Capacité 1 : rechercher une donnée.
    if (!context.scopes.includes("data:search")) {
      throw new Error("Accès refusé");
    }

    // Ici, le serveur interroge une base, un CRM ou un entrepôt de données.
    return {
      results: ["Client A", "Client B"],
      query: input.query
    };
  },

  async triggerAction(input, context) {
    // Capacité 2 : déclencher une action contrôlée.
    if (!context.scopes.includes("action:trigger")) {
      throw new Error("Accès refusé");
    }

    // Ici, on applique les règles métier avant d'agir.
    return {
      status: "queued",
      action: input.actionName
    };
  }
};
Les risques sont classiques, mais ils coûtent cher. Trop de permissions. Pas de journalisation. Des identifiants stockés côté client. Des outils trop puissants sans garde-fous. Dans mes sujets tracking et automatisation, j’ai appris un truc simple : dès qu’un système peut agir, il faut savoir qui a demandé quoi, avec quel contexte, et quel résultat.
- Garder les secrets côté serveur, jamais dans l’agent ni dans le navigateur.
- Appliquer les permissions minimales, avec des scopes précis par capacité.
- Logger les usages, avec utilisateur, outil appelé, contexte, résultat et erreur.
- Valider les entrées, surtout quand l’agent génère lui-même les paramètres.
- Limiter les actions, avec quotas, confirmations ou règles métier.
- Revoir régulièrement les outils exposés, parce qu’une capacité utile aujourd’hui peut devenir risquée demain.
Pourquoi tester les modèles en local ?
Tester les modèles en local, c’est souvent le moyen le plus simple de garder le contrôle. Je peux développer hors ligne, réduire ma dépendance à une API externe, et valider vite un cas d’usage avant de brancher une architecture plus lourde. Et franchement, les petits modèles de langage deviennent assez bons pour beaucoup de tâches, surtout quand le périmètre est clair.
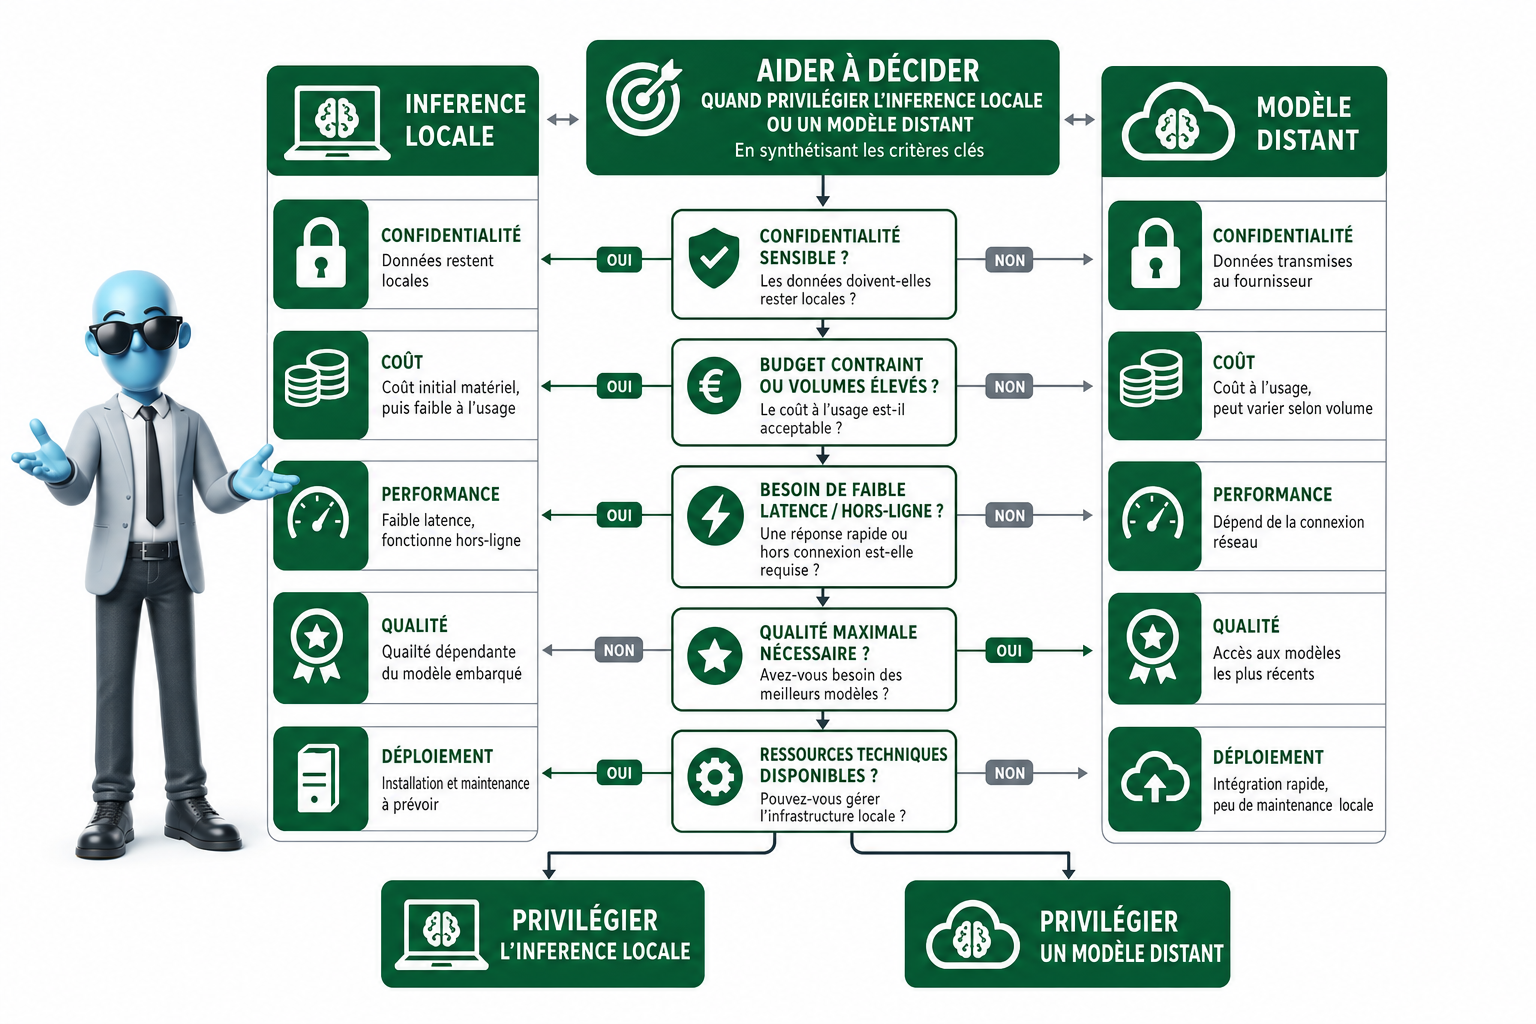
Je pense à des usages très concrets :
- Prototyper une idée sans attendre une clé API ou un budget.
- Classer des textes simples, comme “urgent”, “commercial”, “support”.
- Extraire des champs structurés depuis un message ou un document court.
- Reformuler, résumer court, nettoyer des données répétitives.
- Lancer des tests automatisés dans une chaîne CI, sans appel externe.
- Travailler sur des données sensibles sans les envoyer ailleurs.
- Coder dans un train, dans un client sécurisé, ou sans connexion stable.
La bonne approche en 2026, c’est simple : je commence local, je mesure, puis je décide si j’ai vraiment besoin d’un modèle plus puissant. Ça évite de transformer chaque micro-tâche en appel API coûteux, lent, et parfois difficile à auditer. Chez certains clients, le local sert surtout à valider 80 % des traitements simples. Les gros modèles restent réservés aux 20 % vraiment complexes.
Ce pattern montre l’idée générale : une entrée utilisateur, un prompt court, un appel à un runtime local simulé, une sortie JSON, et une gestion d’erreur propre. C’est utile pour poser une interface stable avant de choisir le moteur réel.
import json

def run_local_model(prompt: str) -> str:
    # Ici, je simule un runtime local.
    # En vrai, ça pourrait appeler Ollama, llama.cpp, vLLM local, ou autre.
    return '{"category": "support", "priority": "medium", "summary": "Demande client à traiter"}'

def infer_locally(user_text: str) -> dict:
    prompt = f"""
    Analyse ce message et réponds uniquement en JSON.
    Champs attendus: category, priority, summary.
    Message: {user_text}
    """

    try:
        raw_output = run_local_model(prompt)
        result = json.loads(raw_output)

        required_fields = {"category", "priority", "summary"}
        if not required_fields.issubset(result):
            raise ValueError("Champs JSON manquants")

        return {"ok": True, "data": result}

    except Exception as error:
        return {
            "ok": False,
            "error": str(error),
            "data": None
        }

print(infer_locally("Bonjour, je n'arrive plus à accéder à mon compte."))
Je reste prudent quand même. Les petits modèles ne remplacent pas toujours les grands. Dès qu’il faut raisonner longtemps, gérer une demande ambiguë, produire une qualité très élevée ou tenir un contexte large, un modèle distant plus puissant peut rester meilleur. Il faut aussi surveiller la latence selon la machine, la mémoire disponible, la qualité variable, les tests de non-régression, et la sécurité des sorties. Un modèle local peut aussi halluciner, produire du JSON cassé, ou répondre avec trop d’assurance.
| Critère | Inférence locale | Modèle distant |
| Coût | Faible à l’usage, coût machine à prévoir | Variable, souvent facturé à l’appel ou au token |
| Confidentialité | Très bonne, les données restent chez vous | Dépend du fournisseur et du contrat |
| Performance | Dépend fortement du matériel local | Souvent stable et optimisée côté fournisseur |
| Qualité | Très correcte sur tâches cadrées | Meilleure sur tâches complexes et ambiguës |
| Déploiement | Plus technique à maintenir | Plus simple au départ, dépendance externe plus forte |
Quel socle pour passer en production ?
Le socle de production minimal combine une orchestration maîtrisée, des connexions standardisées via MCP, des modèles locaux quand c’est pertinent et une gouvernance claire des accès et des erreurs. Ce n’est pas la partie la plus sexy du toolkit IA, clairement. Mais c’est celle qui évite les agents incontrôlables, ceux qui appellent trois outils au hasard, modifient une donnée sensible, puis répondent avec aplomb que tout va bien.
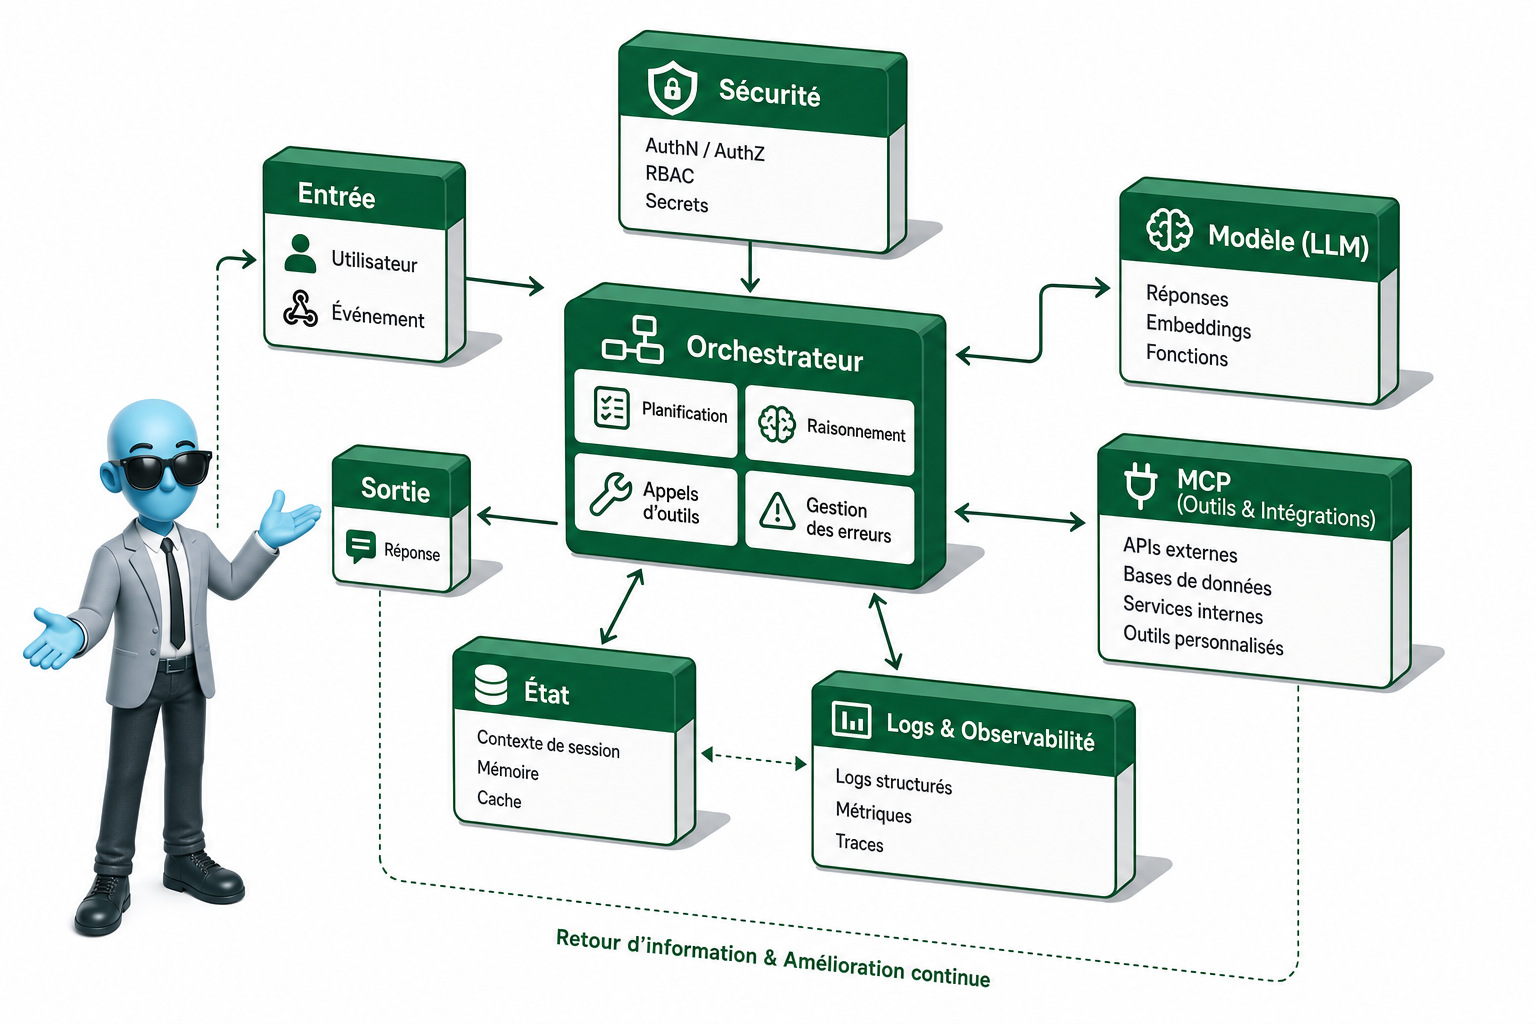
Dans une vraie architecture, chaque brique a son rôle. L’orchestration pilote le comportement de l’agent. MCP, pour Model Context Protocol, expose les outils de manière standardisée, un peu comme une prise universelle entre le modèle et vos systèmes. L’inférence locale accélère le développement et couvre les tâches simples sans appeler un gros modèle distant à chaque fois. La gouvernance empêche l’agent de faire n’importe quoi avec les données, les droits ou les actions business.
Une architecture minimale ressemble à ça. L’utilisateur, ou un événement entrant, déclenche une demande. L’orchestrateur décide quoi faire et dans quel ordre. Le modèle raisonne ou génère une réponse. Le serveur d’outils MCP donne accès aux actions disponibles. Le système business exécute vraiment les opérations, comme créer un ticket ou lire un CRM. Le stockage d’état conserve le contexte et la mémoire utile. Les logs gardent une trace exploitable. Les règles de sécurité valident les permissions, les limites et les erreurs.
Ce pseudo-code montre le flux de base que j’aime poser chez les clients avant de parler framework. Ça reste générique, mais c’est souvent suffisant pour repérer les trous dans la raquette.
# Flux générique d'un agent prêt pour la production

def handle_request(user_id, request):
    # Charger l'état pour garder le contexte multi-tours
    state = state_store.load(user_id)

    # Préparer le contexte envoyé au modèle
    context = {
        "request": request,
        "state": state,
        "available_tools": mcp_server.list_tools(user_id)
    }

    # Appeler le modèle pour décider de la prochaine action
    decision = model.generate(context)

    # Vérifier que l'action demandée est autorisée
    if decision.action:
        allowed = policy_engine.is_allowed(
            user_id=user_id,
            action=decision.action,
            data=decision.arguments
        )

        if not allowed:
            logs.write(user_id, "Action refusée", decision)
            return "Je ne peux pas faire cette action sans validation."

        # Appeler l'outil exposé via MCP
        result = mcp_server.call_tool(
            name=decision.action,
            arguments=decision.arguments
        )

        # Enregistrer le résultat et mettre à jour l'état
        state_store.save(user_id, result)
        logs.write(user_id, "Action exécutée", result)

        return model.final_answer(request, result)

    # Répondre sans action si le modèle n'a besoin que de générer du texte
    logs.write(user_id, "Réponse simple", decision)
    return decision.answer
Le choix du bon toolkit dépend surtout de votre réalité. La complexité du workflow compte. Le besoin de mémoire multi-tours aussi. Le niveau de risque des actions change tout, parce qu’envoyer un email brouillon et déclencher un remboursement client, ce n’est pas le même monde. La sensibilité des données, le volume d’exécution et la compétence de l’équipe pèsent autant que la beauté du framework. Le bon toolkit n’est pas universel. Les primitives, elles, restent les mêmes.
- Erreurs gérées : Chaque échec outil, modèle ou réseau a un comportement prévu.
- État traçable : Chaque décision importante peut être reliée à un contexte.
- Accès limités : Chaque outil respecte des permissions claires.
- Outils documentés : Chaque action MCP décrit ses entrées, sorties et limites.
- Tests de scénarios : Les cas normaux, limites et dangereux sont testés.
- Logs exploitables : Les traces permettent de comprendre et corriger vite.
- Fallback humain : Les actions risquées peuvent être bloquées ou validées par une personne.
Et maintenant on garde quoi dans la boîte à outils ?
Je garderais une stack courte : une bonne orchestration, un standard de connexion comme MCP, des petits modèles locaux quand ils suffisent, et une vraie discipline sur les accès, l’état et les erreurs. Le reste vient après. C’est souvent là que les équipes se trompent : elles ajoutent des couches avant d’avoir stabilisé les primitives. En 2026, l’ingénieur IA efficace n’est pas celui qui empile le plus d’outils, c’est celui qui sait faire tourner un système autonome sans perdre le contrôle. Le bénéfice pour vous est simple : moins de complexité, plus de fiabilité, et une IA plus facile à mettre en production.
FAQ
- Quel est le toolkit minimal d’un ingénieur IA en 2026 ?
Le toolkit minimal repose sur trois blocs : une orchestration fiable, un protocole de connexion aux outils et données comme MCP, et l’inférence locale avec des petits modèles quand le cas d’usage le permet. J’ajoute surtout une couche de gouvernance : droits, état, erreurs, logs et limites d’action. - Pourquoi l’orchestration est si importante pour les agents IA ?
Parce qu’un agent autonome doit être contrôlé. L’orchestration permet de gérer les étapes, la mémoire, les erreurs, les retries, les fallbacks et les décisions conditionnelles. Sans ça, on a souvent une démo impressionnante, mais pas un système robuste en production. - MCP remplace-t-il les connecteurs sur mesure ?
MCP réduit fortement le besoin de wrappers spécifiques en standardisant la façon dont un agent accède aux outils et aux données. Mais il ne supprime pas le travail d’architecture. Il faut toujours gérer les droits, les secrets, les limites d’action et la traçabilité côté serveur. - Les petits modèles locaux suffisent-ils pour construire une IA business ?
Ils suffisent pour beaucoup de tâches ciblées : extraction, classification, reformulation, résumé court, tests, traitement local ou prévalidation. Pour les raisonnements longs, les tâches ambiguës ou les sorties critiques, un modèle plus puissant reste souvent nécessaire. - Comment savoir si un agent IA est prêt pour la production ?
Je regarde d’abord si son état est traçable, si ses erreurs sont gérées, si ses accès sont limités, si ses outils sont documentés et si un fallback humain existe pour les cas risqués. Si personne ne peut expliquer ce que l’agent a fait et pourquoi, il n’est pas prêt.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer de l’idée IA au système réellement exploitable, avec des sujets très concrets : données, automatisation, gouvernance, mesure et mise en production. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer ou industrialiser vos projets IA, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.