
Je réduis le coût d’un SLM en réutilisant le préfixe fixe du prompt avec un cache KV. Le gain vient surtout du pré-remplissage évité. On va voir quand ça marche, comment le vérifier proprement, et comment le coder sans casser l’alignement des tokens.
Pourquoi le préfixe coûte si cher ?
Quand je regarde une automatisation IA qui rame, je trouve souvent le même problème : on fait relire au modèle des pages entières pour traiter trois lignes qui changent.
Le cas typique, c’est un workflow business avec un prompt très long. On y met les instructions, les exemples de réponses attendues, une taxonomie métier, des règles de décision, parfois même des contre-exemples. Tout ça, ce sont des tokens statiques. Ils ne changent presque jamais. Puis à la fin, on colle la partie vraiment utile du moment : un ticket client, un mail, une demande support. Ça, ce sont les tokens variables.
Le problème, c’est que sans optimisation, le modèle refait le même boulot à chaque appel. Il repasse par la phase de pré-remplissage, ou prefill, où il lit tout le prompt avant de générer ou scorer la sortie. Sur un gros serveur GPU, ça se voit déjà. Sur un petit modèle local, ou dans un workflow low code qui appelle le modèle ticket par ticket, ça devient vite absurde.
J’ai vu ce cas chez un client avec une classification de tickets. Le prompt contenait une grosse grille de décision, puis un ticket de 80 mots. Le modèle relisait la grille complète à chaque ticket. Le vrai travail métier était petit, mais le coût venait du contexte répété.
Avec un SLM comme Qwen2.5-0.5B-Instruct, c’est un bon terrain de test parce qu’il est léger et facile à lancer localement. Je ne promets pas des gains universels, ça dépend du hardware, du moteur d’inférence et de la forme du prompt. Mais le raisonnement tient : si le préfixe ne change pas, le recalculer est une perte.
Le cache KV sert justement à garder les clés et valeurs d’attention déjà calculées pour ce préfixe. La documentation Hugging Face Transformers sur les caches d’inférence explique ce mécanisme côté génération. Les docs vLLM sur l’automatic prefix caching vont dans le même sens : réutiliser automatiquement les préfixes identiques pour éviter de refaire le prefill.
Et même quand on ne génère pas librement, mais qu’on fait du scoring contraint, par exemple choisir entre “bug”, “facturation”, “résiliation” ou “autre”, le sujet reste le même. Le préfixe stable prépare le contexte. La petite partie variable change le score final. Autant ne pas repayer tout le contexte à chaque fois.
| situation | problème | idée d’optimisation |
| Prompt long avec règles métier stables | Le modèle recalcule les mêmes tokens à chaque appel | Mettre le bloc stable dans un préfixe réutilisable |
| Ticket client court ajouté à la fin | Le coût vient surtout du pré-remplissage | Ne recalculer que les tokens variables |
| Classification par scoring contraint | Chaque label est scoré après le même contexte | Réutiliser le cache KV du préfixe commun |
Comment fonctionne le cache KV ?
Le cache KV, c’est une idée assez simple quand on enlève le jargon. Dans un transformeur causal, le modèle lit les tokens de gauche à droite. À chaque nouveau token, il calcule des informations d’attention pour comprendre à quoi ce token doit “regarder” dans le passé.
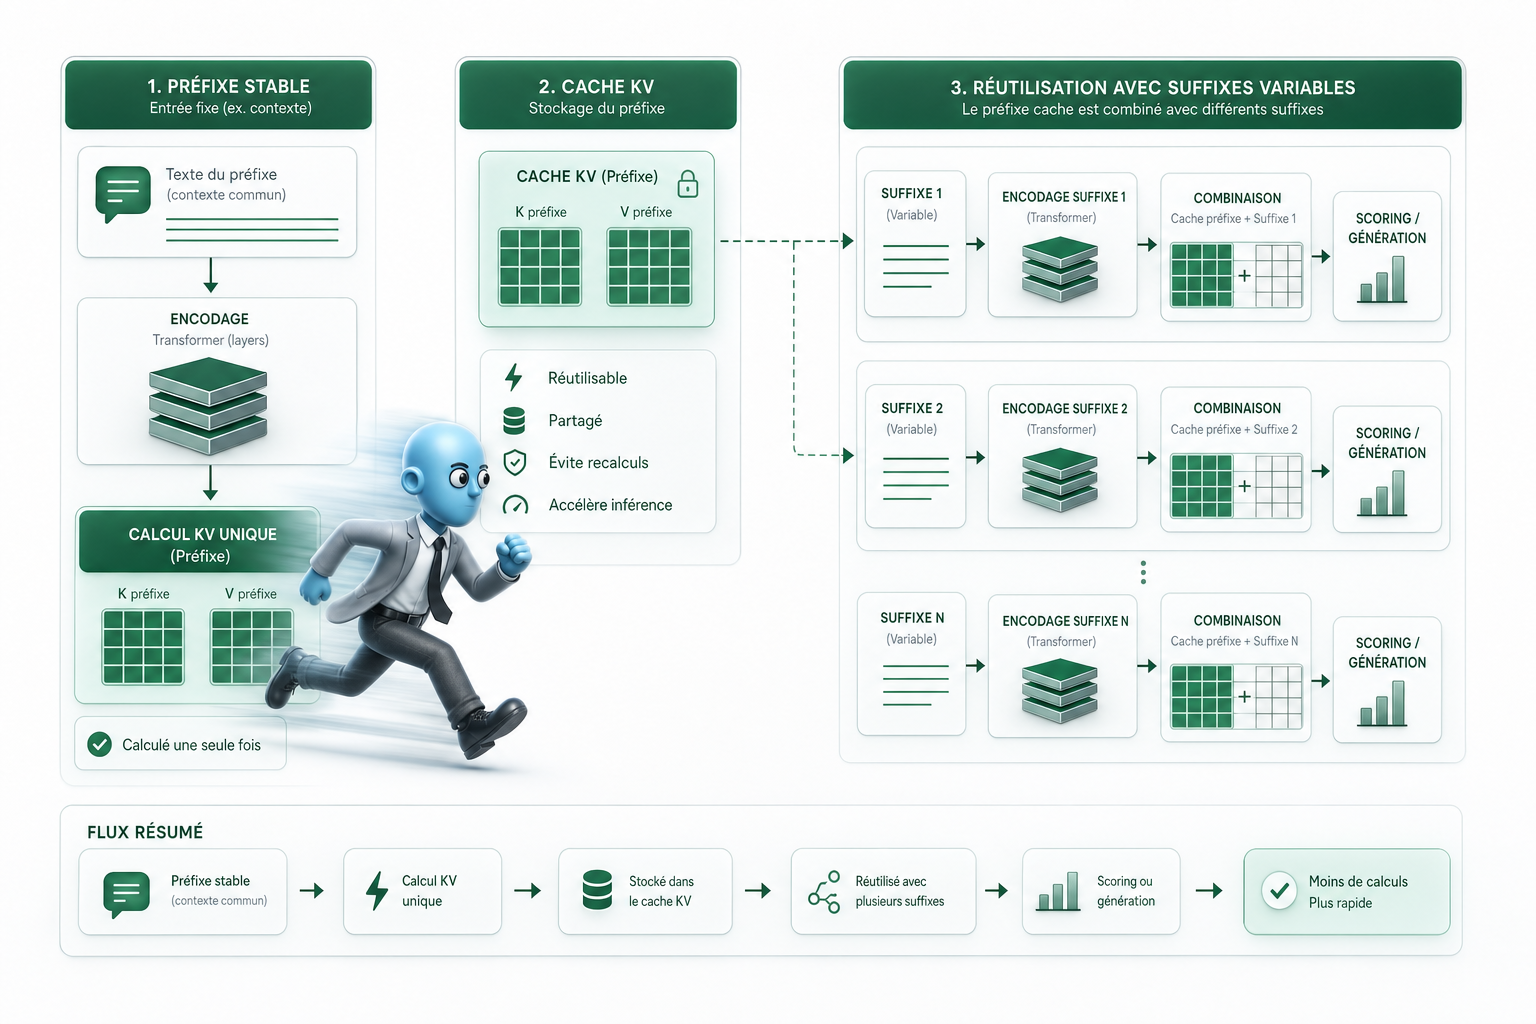
K veut dire Key, la clé. V veut dire Value, la valeur. La clé sert à retrouver les tokens utiles dans le contexte. La valeur contient l’information qu’on va réellement réutiliser une fois qu’un token est jugé important. L’attention compare le token courant avec les clés des tokens précédents, puis récupère les valeurs associées. C’est comme dire : “Dans tout ce que j’ai déjà lu, qu’est-ce qui m’aide à prédire le prochain mot ?”
Le point important, c’est que les clés et les valeurs d’un token dépendent uniquement des tokens avant lui, plus lui-même. Pas des tokens qui arrivent après. Donc si je donne toujours le même début de prompt au modèle, il va produire les mêmes Key et Value pour cette partie. Ce préfixe devient réutilisable. Pas besoin de recalculer les instructions, les règles, les exemples, les labels, encore et encore.
Je le vois souvent sur des cas de classification de tickets. Le prompt contient des instructions fixes, une liste de labels fixe, quelques exemples fixes, puis le ticket client à classer. Toute la première partie peut être mise en cache. Seul le ticket change. Le modèle repart alors d’un état déjà prêt, ce qui réduit la latence et le coût de calcul.
La limite est brutale mais saine à garder en tête. Si le moindre token du préfixe change, même un espace, une virgule, une casse différente, le cache n’est plus exactement le même. On ne parle pas d’un texte “presque pareil”. On parle d’une suite de tokens identique.
Ce principe est documenté dans les frameworks modernes d’inférence. Hugging Face Transformers expose ça avec past_key_values. vLLM parle de prefix caching. NVIDIA TensorRT-LLM gère aussi le KV cache pour accélérer l’inférence.
- Le préfixe doit être strictement identique au niveau des tokens.
- Le même tokenizer doit être utilisé.
- Le même modèle et les mêmes poids doivent être utilisés.
- Les paramètres qui influencent le calcul interne ne doivent pas changer.
- Le contenu variable doit être placé après la partie fixe mise en cache.
- Le cache doit être invalidé dès qu’un token du préfixe change.
Comment mesurer le prompt réutilisable ?
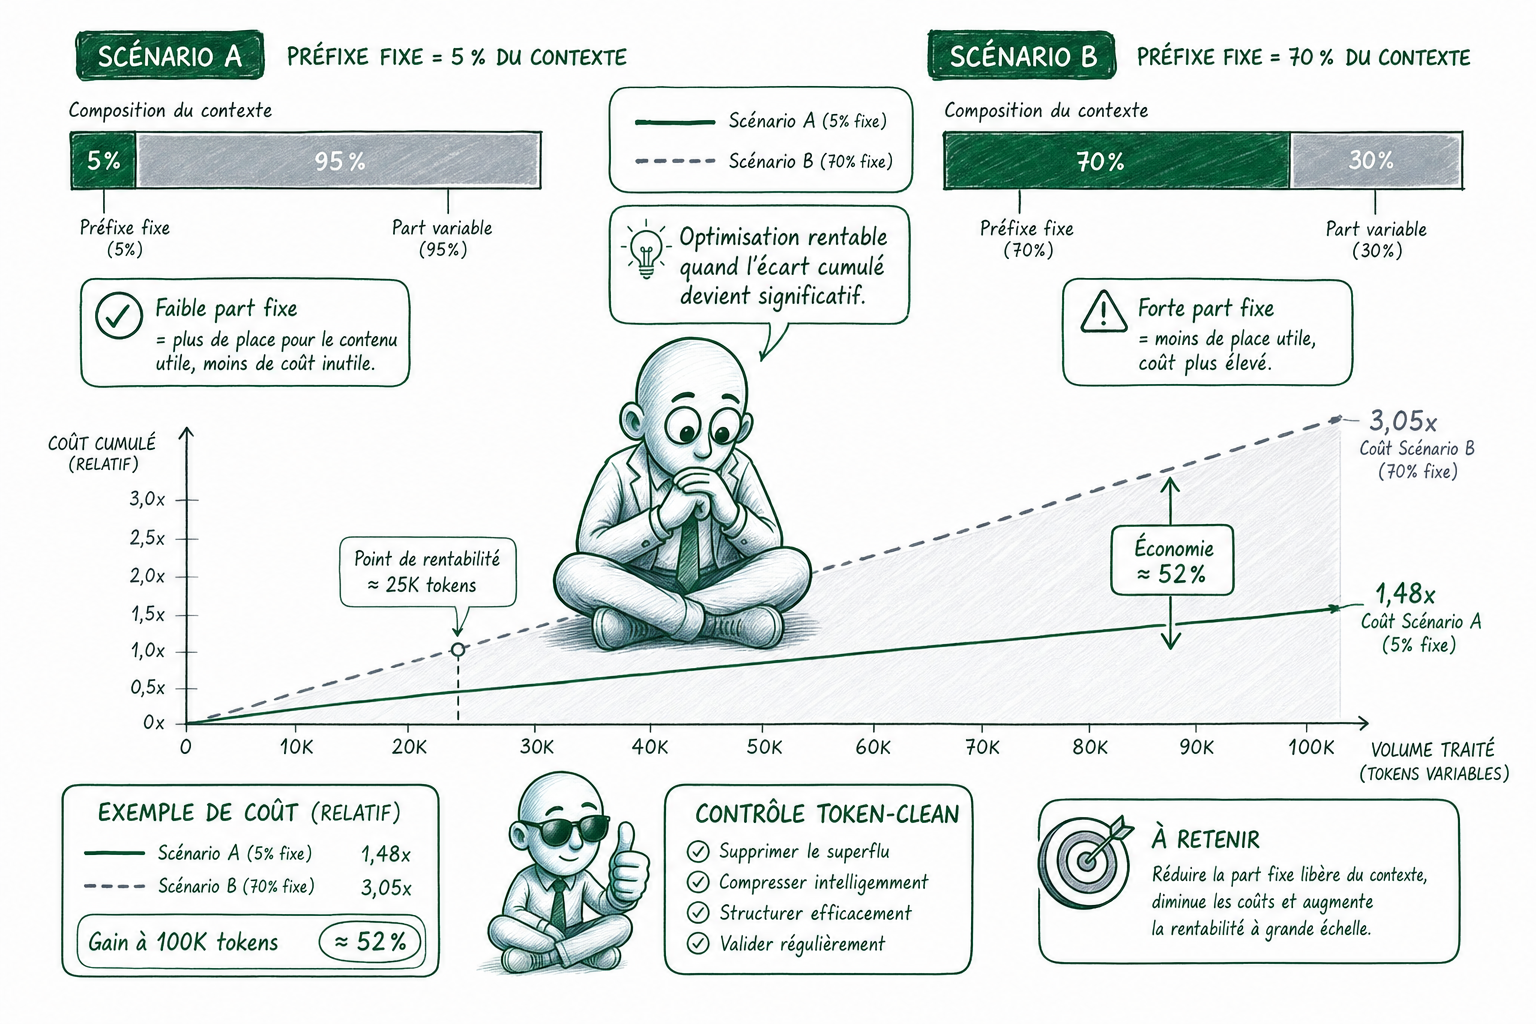
Je commence toujours par mesurer le prompt réutilisable. Sinon on optimise à l’aveugle. Le cache KV sert à éviter de recalculer les clés et valeurs d’attention sur une partie déjà connue du prompt. Donc si votre préfixe fixe représente 5% du prompt, l’impact sera faible. S’il représente 70%, là ça devient intéressant.
Le point que je vérifie avant tout, c’est la séparation token-clean. Ça veut dire une chose simple : tokenizer le préfixe + le suffixe ensemble doit produire exactement les mêmes tokens que tokenizer le préfixe seul, puis le suffixe seul, et concaténer les deux. Si ce n’est pas vrai, le cache KV sera aligné sur de mauvais tokens. Et là, vous pouvez avoir des scores incohérents sans erreur visible. J’ai déjà vu ça chez un client sur un prompt de classification, juste à cause d’un espace déplacé.
Voici un script minimal pour mesurer ça sur votre machine, avec votre vrai prompt ensuite.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_id = "Qwen/Qwen2.5-0.5B-Instruct"

# Choisit le meilleur device disponible.
if torch.cuda.is_available():
    device = "cuda"
    dtype = torch.float16
elif torch.backends.mps.is_available():
    device = "mps"
    dtype = torch.float32
else:
    device = "cpu"
    dtype = torch.float32

tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=dtype
).to(device)

model.eval()

tickets = [
    "Le client ne peut plus se connecter depuis ce matin.",
    "Je voudrais ajouter le paiement annuel dans mon abonnement.",
    "La facture de mars semble incorrecte."
]

labels = ["Bug", "Feature", "Billing", "Question"]

# Vérifie que chaque label commence par un token différent.
first_tokens = {}
for label in labels:
    ids = tokenizer.encode(label, add_special_tokens=False)
    if not ids:
        raise ValueError(f"Label vide ou non tokenisable: {label}")
    first_token = ids[0]
    if first_token in first_tokens:
        raise ValueError(
            f"Collision de premier token: {label} et {first_tokens[first_token]}"
        )
    first_tokens[first_token] = label

# Préfixe fixe réutilisable avec le cache KV.
prefix = (
    "<|im_start|>systemn"
    "Tu classes des tickets support. "
    "Réponds uniquement avec un label parmi: "
    + ", ".join(labels)
    + ".n"
    "<|im_end|>n"
    "<|im_start|>usern"
    "Classe le ticket suivant.n"
    "Ticket:n"
)

def build_suffix(ticket: str) -> str:
    # Suffixe variable, différent pour chaque ticket.
    return (
        ticket
        + "n<|im_end|>n"
        + "<|im_start|>assistantn"
    )

prefix_ids = tokenizer.encode(prefix, add_special_tokens=False)
print("Device:", device)
print("Longueur prefix tokens:", len(prefix_ids))

for ticket in tickets:
    suffix = build_suffix(ticket)

    full_ids = tokenizer.encode(prefix + suffix, add_special_tokens=False)
    suffix_ids = tokenizer.encode(suffix, add_special_tokens=False)
    concat_ids = prefix_ids + suffix_ids

    # Contrôle critique avant cache KV.
    if full_ids != concat_ids:
        raise ValueError(
            "Séparation non token-clean. "
            "Modifiez la frontière prefix/suffix avant d'utiliser un cache KV."
        )

    static_share = len(prefix_ids) / len(full_ids)

    print("nTicket:", ticket)
    print("Longueur prompt complet tokens:", len(full_ids))
    print("Part statique:", round(static_share * 100, 2), "%")
Je ne donne pas de chiffres ici, parce qu’ils n’ont aucun intérêt hors contexte. Il faut mesurer sur votre machine, votre tokenizer, votre template exact, et vos vrais tickets. Le moindre saut de ligne peut changer la tokenisation.
| Contrôle | Pourquoi c’est important |
| Longueur du préfixe fixe | Estime la partie vraiment réutilisable avec le cache KV. |
| Longueur du prompt complet | Permet de calculer la part statique réelle. |
| Labels avec premier token unique | Rend possible un scoring contraint fiable sur le premier token. |
| Séparation token-clean | Garantit que le cache KV correspond exactement aux bons tokens. |
| Mesure sur le vrai prompt | Évite les optimisations théoriques qui ne tiennent pas en production. |
Comment coder la réutilisation du cache ?
Le principe est simple. Je garde tout ce qui ne bouge pas dans un préfixe fixe, je le passe une seule fois dans le modèle, puis je réutilise son cache KV pour chaque ticket. Le cache KV, c’est la mémoire interne des clés et valeurs d’attention déjà calculées. Ça évite au SLM de relire la consigne complète à chaque fois.
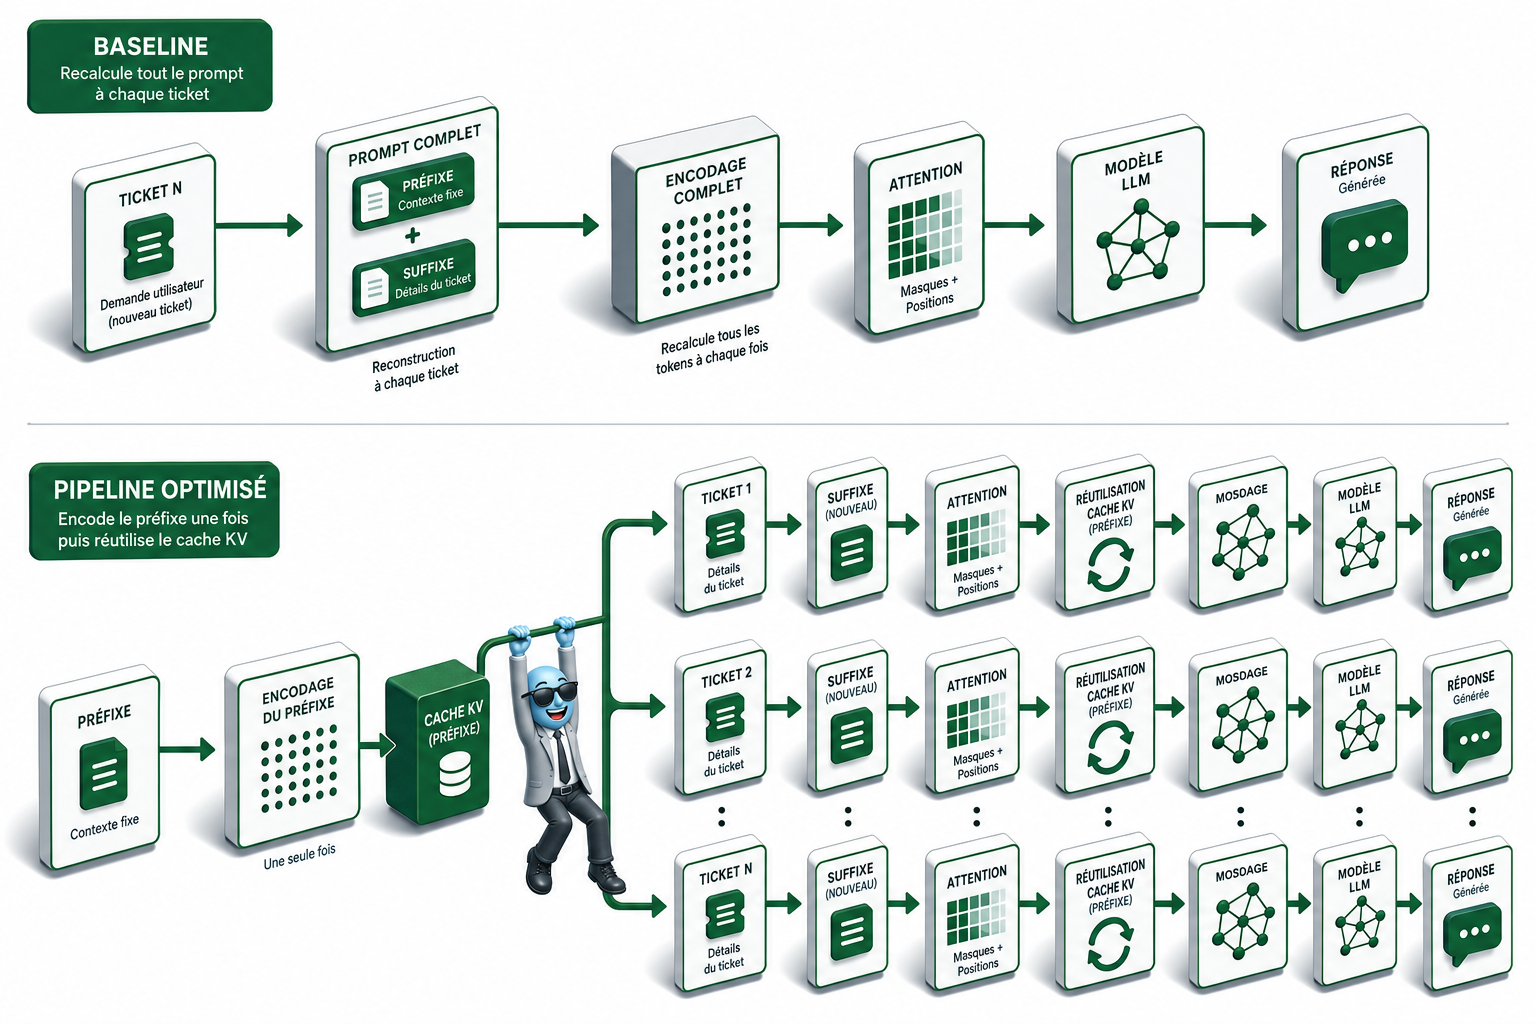
Voici un exemple complet. Il compare une baseline sans cache et une version avec cache, en scorant seulement le premier token de chaque label. C’est souvent suffisant pour une classification courte, du type “bug”, “billing”, “security”.
import time
import copy
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "HuggingFaceTB/SmolLM2-360M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name).eval()

device = "cuda" if torch.cuda.is_available() else "cpu"
model.to(device)

prefix = (
    "Tu classes des tickets support.n"
    "Labels possibles: bug, billing, security.n"
    "Réponds avec un seul label.nn"
    "Ticket: "
)

labels = ["bug", "billing", "security"]
tickets = [
    "Le paiement est passé deux fois sur ma carte.",
    "Impossible de me connecter depuis la dernière mise à jour.",
    "Je pense que mon compte a été compromis."
]

# On score le premier token de chaque label.
label_token_ids = {
    label: tokenizer.encode(label, add_special_tokens=False)[0]
    for label in labels
}

def pick_label_from_logits(logits):
    # Les logits sont les scores bruts du prochain token.
    scores = {
        label: logits[label_token_id].item()
        for label, label_token_id in label_token_ids.items()
    }
    return max(scores, key=scores.get)

def clone_past(past):
    # Certains caches peuvent être mutés par le framework.
    # Une copie évite qu'un ticket pollue le suivant.
    return copy.deepcopy(past)

baseline_results = []
t0 = time.perf_counter()

with torch.no_grad():
    for ticket in tickets:
        prompt = prefix + ticket + "nLabel:"
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        outputs = model(**inputs, use_cache=False)
        next_logits = outputs.logits[0, -1, :]

        baseline_results.append(pick_label_from_logits(next_logits))

baseline_time = time.perf_counter() - t0

# Version optimisée: on encode le préfixe une seule fois.
prefix_inputs = tokenizer(prefix, return_tensors="pt").to(device)

with torch.no_grad():
    prefix_outputs = model(**prefix_inputs, use_cache=True)
    prefix_cache = prefix_outputs.past_key_values
    prefix_len = prefix_inputs["input_ids"].shape[1]

cached_results = []
t1 = time.perf_counter()

with torch.no_grad():
    for ticket in tickets:
        suffix = ticket + "nLabel:"
        suffix_inputs = tokenizer(
            suffix,
            return_tensors="pt",
            add_special_tokens=False
        ).to(device)

        suffix_len = suffix_inputs["input_ids"].shape[1]
        total_len = prefix_len + suffix_len

        attention_mask = torch.ones((1, total_len), device=device)

        # Utile avec certains modèles ou versions Transformers.
        position_ids = torch.arange(
            prefix_len,
            total_len,
            device=device
        ).unsqueeze(0)

        outputs = model(
            input_ids=suffix_inputs["input_ids"],
            attention_mask=attention_mask,
            position_ids=position_ids,
            past_key_values=clone_past(prefix_cache),
            use_cache=True
        )

        next_logits = outputs.logits[0, -1, :]
        cached_results.append(pick_label_from_logits(next_logits))

cached_time = time.perf_counter() - t1

print("Baseline:", baseline_results, round(baseline_time, 4), "s")
print("Cache KV:", cached_results, round(cached_time, 4), "s")
print("Même résultat:", baseline_results == cached_results)
Les points sensibles sont presque toujours les mêmes. L’attention_mask doit couvrir le préfixe plus le suffixe, pas seulement le suffixe. Les position_ids peuvent être nécessaires selon le modèle, surtout si le framework ne les reconstruit pas correctement avec past_key_values. Le cache peut être mutable, donc je le copie quand j’ai un doute. Et si le préfixe change, même d’un espace, je ne réutilise pas le cache.
Sur le batching, je reste prudent. Si les tickets ont des longueurs différentes, il faut gérer le padding, les masques et parfois les positions à la main. Chez un client, on avait gagné du temps sur le modèle, puis tout perdu dans un batching bricolé. Le chrono avec time.perf_counter suffit déjà pour vérifier si l’optimisation vaut le coup dans votre cas, sans promettre un ratio magique.
- Réutiliser le cache avec un préfixe légèrement différent. Ça donne des résultats incohérents.
- Oublier add_special_tokens=False sur le suffixe. Le modèle reçoit alors des tokens inattendus.
- Passer un attention_mask trop court. Le modèle ne voit pas correctement le contexte total.
- Ne pas comparer avec une baseline. On croit optimiser, mais on change parfois la prédiction.
- Muter le même cache entre plusieurs tickets. C’est discret, et ça fait perdre des heures.
Alors le cache KV vaut le coup pour votre SLM ?
Le cache KV vaut vraiment le coup quand votre prompt est long, stable, et répété souvent. Dans ce cas, je ne demande pas au modèle de refaire le même travail à chaque ticket. Je pré-calcule le préfixe, je vérifie que la coupure est propre côté tokens, puis je ne traite que la partie variable. C’est simple en théorie, un peu plus exigeant en code, surtout avec les caches mutables et l’alignement. Mon conseil: mesurez d’abord, optimisez ensuite. Le bénéfice pour vous est clair: moins de latence, moins de calcul, et des automatisations IA plus réalistes en production.
FAQ
- Qu’est-ce qu’un cache KV dans un modèle de langage ?
Un cache KV stocke les clés et valeurs d’attention déjà calculées par le modèle. Sur un modèle causal, ces états dépendent des tokens précédents. Si le début du prompt ne change pas, je peux réutiliser ces états au lieu de les recalculer à chaque requête. - Quand le prefix caching est-il vraiment utile ?
Il devient intéressant quand une grosse partie du prompt reste identique: instructions, exemples, règles, taxonomie, labels. Si seule la fin change, comme un ticket client ou une ligne de données, le cache KV peut réduire le coût du pré-remplissage. - Pourquoi faut-il vérifier que la coupure est token-clean ?
Parce que le modèle ne travaille pas sur du texte brut, il travaille sur des tokens. Si encoder le préfixe et le suffixe séparément ne donne pas les mêmes ids que l’encodage complet, le cache ne correspond plus exactement au prompt réel. Et là, les résultats peuvent devenir faux. - Est-ce que le cache KV améliore la qualité des réponses ?
Non, pas directement. Le cache KV sert surtout à accélérer l’inférence et à réduire le calcul. Si le prompt, le modèle et les tokens restent identiques, la sortie doit rester équivalente. On optimise l’exécution, pas le raisonnement du modèle. - Peut-on utiliser cette approche avec un workflow low code ?
Oui, mais souvent via un service Python ou une API interne qui gère le modèle et le cache. L’outil low code comme n8n peut orchestrer les tickets, les appels et les sorties. La partie cache KV reste plutôt côté service d’inférence.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent mettre de l’IA en production sans transformer chaque workflow en usine à gaz. Références clients: Logis Hôtel, Yelloh Village, BazarChic, Fédération Française de Football, Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer ou optimiser vos automatisations IA, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.