
Pi est gratuit à télécharger et à exécuter, mais pas nécessairement gratuit à utiliser. Je détaille ce qui est facturé par les fournisseurs, comment le mode code peut réduire les jetons et pourquoi le cache ou les modèles spécialisés pèsent aussi dans le coût.
Pi est-il vraiment gratuit ?
Pi est gratuit comme logiciel, mais son utilisation peut entraîner des frais. Je peux télécharger et exécuter Pi sans payer de licence ni d’abonnement à Pi. Ça ne signifie pas que toutes les ressources mobilisées par l’agent sont gratuites.
Pi est un environnement d’exécution d’agent, pas un modèle d’intelligence artificielle. Il orchestre les échanges avec un modèle, conserve le contexte utile et déclenche des outils selon les besoins. Le modèle, lui, produit les réponses ou le code. Cette distinction compte : Pi pilote l’exécution, mais ne fournit pas automatiquement la capacité de calcul du modèle.
Les frais éventuels viennent des services connectés à Pi. Selon la configuration et les tâches lancées, ils peuvent inclure :
- Les requêtes envoyées à un fournisseur de modèles, facturées selon son offre et le volume consommé.
- L’utilisation de classificateurs ou de générateurs d’images fournis par des services tiers.
- Certaines opérations d’infrastructure, comme l’hébergement, le stockage ou l’exécution de tâches sur des serveurs.
Le montant dépend donc des fournisseurs choisis, des modèles utilisés, de la fréquence des appels et de la quantité de données traitée. Une exécution avec un modèle local peut éviter une facture d’API, mais elle mobilise votre propre matériel et son énergie. J’ai déjà vu des prototypes rester quasi gratuits, puis générer des coûts dès que les appels au modèle se multiplient en production. Le logiciel n’avait pas changé ; le volume d’usage, si.
Je ne peux donc pas associer Pi à un tarif fixe ou à un abonnement Pi. Pour estimer le coût réel, il faut regarder chaque service appelé et la manière dont il facture son usage. C’est ce modèle de facturation, et les postes à surveiller, que je détaille dans le chapitre suivant.
D’où viennent les coûts de Pi ?
L’essentiel des dépenses de Pi vient des appels facturés par les fournisseurs d’API. Pi sert alors d’interface : le coût dépend surtout des services sollicités et du volume traité, pas d’un abonnement Pi identifié dans les informations disponibles.
Les principaux postes à surveiller sont les suivants :
- Les requêtes envoyées aux modèles, dont le coût varie selon le fournisseur, le modèle et le volume de jetons. Un jeton est une unité de texte traitée par le modèle ; ce n’est pas nécessairement un mot.
- Les appels à des modèles spécialisés utilisés en mode code. Ils peuvent s’ajouter aux requêtes principales, selon les tâches demandées et la configuration.
- Les opérations de rafraîchissement ou de préchauffage du cache. Le cache conserve temporairement des données pour les réutiliser plus vite ; son actualisation peut déclencher de nouveaux appels au fournisseur.

Les journaux ne suffisent pas toujours à calculer la facture réelle. Certains appels peuvent y apparaître sans montant associé, notamment lorsqu’aucun prix n’est répertorié pour le fournisseur ou le modèle concerné. Il faut alors rapprocher les événements des relevés de facturation du fournisseur. Un journal complet n’est pas forcément un relevé de coûts complet.
D’après les informations disponibles, Pi ne facture ni abonnement ni licence. Ça ne signifie pas que son usage est gratuit : les appels aux API peuvent rester payants et sont généralement facturés par les fournisseurs concernés. Je ne donne pas de tarif ici, car il dépend du service utilisé et doit être vérifié dans sa grille de prix à jour.
Le mode code peut modifier le volume de jetons transmis, par exemple en ajoutant du contexte utile au modèle. Il peut donc changer le coût, mais ne garantit pas une économie systématique.
Le mode code réduit-il la facture ?
Le mode code peut réduire le nombre de jetons de contexte envoyés au modèle, mais l’économie dépend de la tâche et de la configuration. Il ne rend pas Pi automatiquement moins cher : il change surtout la façon dont les outils et leurs résultats sont transmis au modèle.

Le mécanisme est simple. Au lieu d’envoyer au modèle de longues descriptions d’outils et des résultats volumineux, l’agent écrit un programme JavaScript qui appelle les outils, filtre et combine leurs réponses, puis renvoie au modèle un résumé concis. Le modèle traite alors moins de texte dans sa requête. Cette approche est surtout utile quand plusieurs outils produisent beaucoup de données dont seule une partie est pertinente.
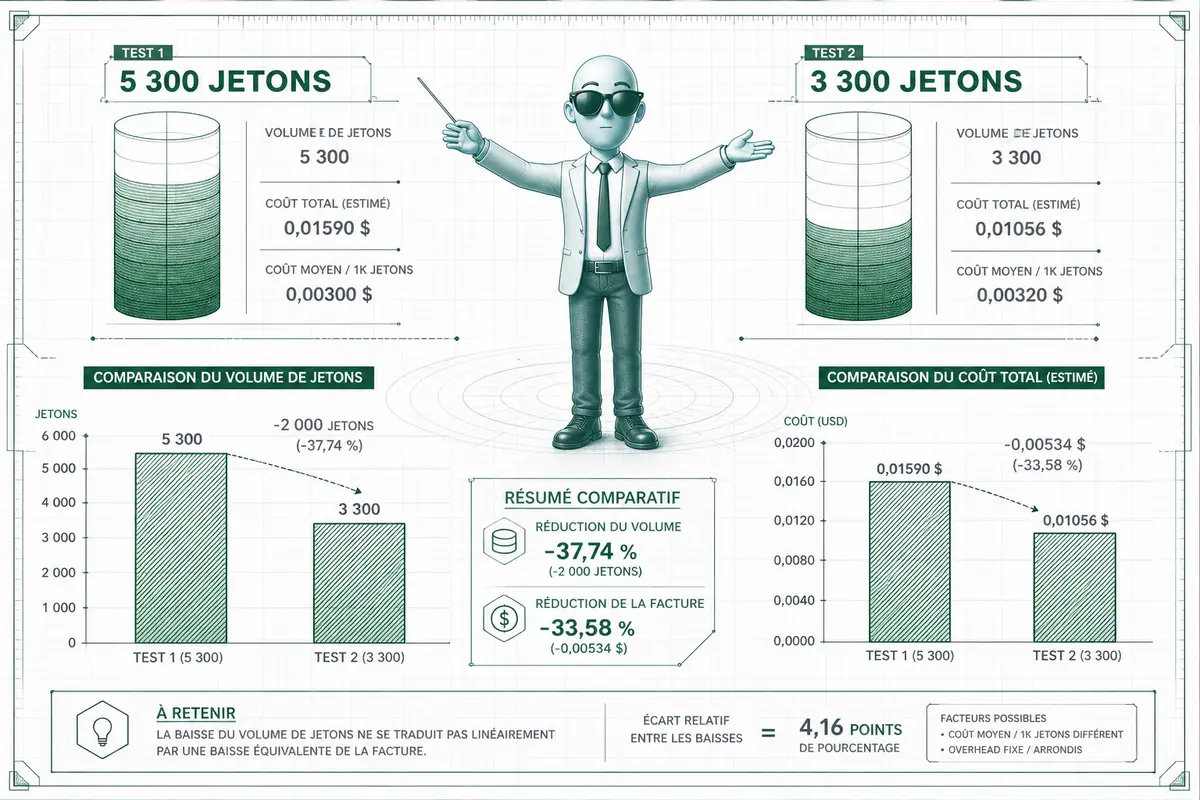
Un test cité est passé d’environ 5 300 à 3 300 jetons de requête, soit près de 40 % de moins dans cette configuration précise. C’est un résultat mesuré sur ce test, pas une économie attendue pour toutes les sessions. Une tâche simple, avec peu de résultats à traiter, peut offrir un gain faible ou nul. Les appels spécialisés peuvent aussi contribuer aux coûts, même si le mode code réduit les jetons transmis au modèle.
Il faut donc distinguer la baisse des jetons de contexte d’une baisse équivalente de la facture totale. Sans connaître les tarifs appliqués, le détail des appels et la configuration de la session, on ne peut pas convertir ce chiffre en économie financière fiable. Le mode code est un levier d’optimisation, pas une garantie de gratuité.
Pour évaluer le coût réel, il faut regarder le mode code avec les autres paramètres de session : modèles utilisés, outils appelés, volume des résultats et durée des échanges. C’est leur combinaison qui détermine la consommation, pas le seul choix du mode.
Quels autres réglages influencent le coût ?
Le routage entre modèles et la gestion du cache peuvent modifier vos dépenses. Ils ne correspondent pas à des frais de licence : selon les informations disponibles, Pi ne facture pas de licence.
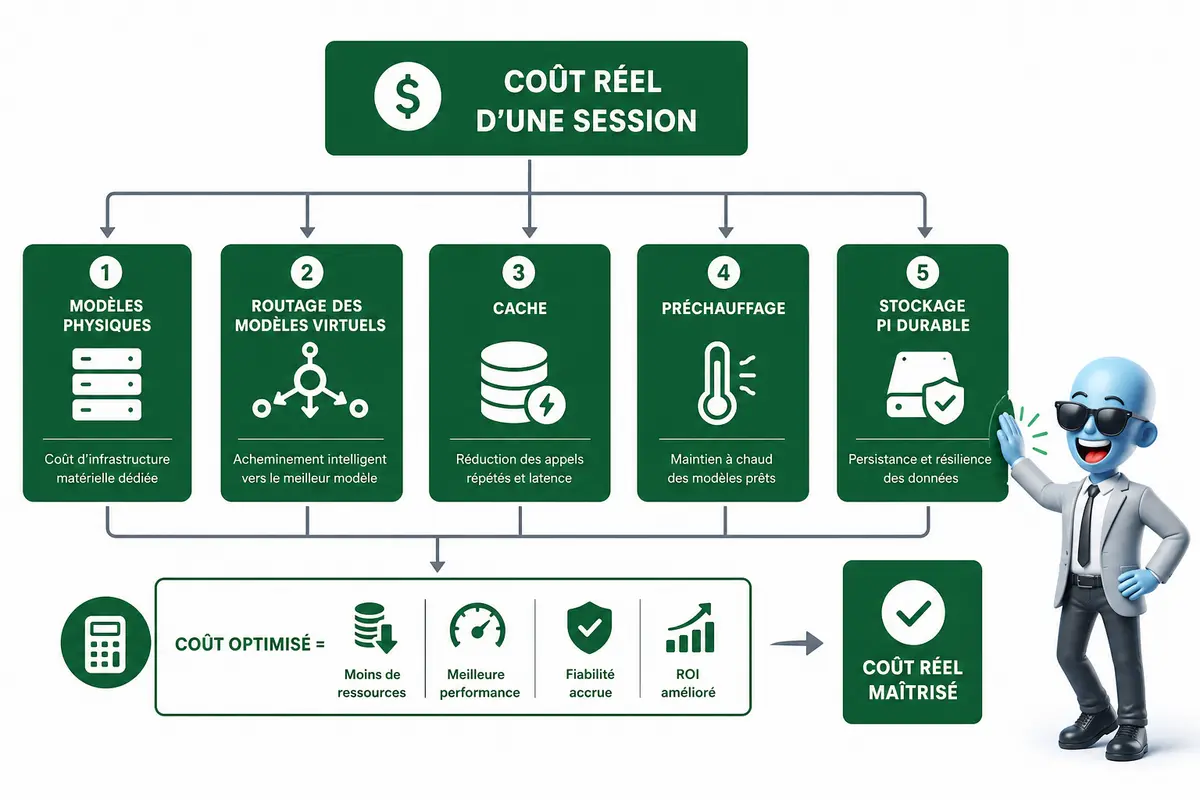
Les modèles virtuels permettent de combiner plusieurs modèles physiques. Mais le routage ne se règle pas tout seul : vous devez choisir les modèles concernés et configurer les règles qui déterminent leur utilisation. Le coût dépend alors des modèles effectivement sollicités et de votre configuration.
Le cache mérite aussi d’être suivi. Si vous changez de modèle physique pendant une session, le cache peut ne pas être réutilisable. Le préchauffage du cache peut également apparaître dans les coûts de session. En pratique, comparer deux configurations sans tenir compte de ces effets peut fausser l’évaluation.
Je garde Pi Durable à part. C’est un paquet expérimental distinct, pas un frais de licence de Pi. Ses choix de stockage ont des conséquences sur la fiabilité. Ils doivent donc être évalués comme des décisions d’architecture, sans les confondre avec la facturation des modèles.
Avant d’évaluer le coût total, je vérifie les postes suivants :
- Les modèles physiques activés derrière chaque modèle virtuel.
- Les règles de routage et les modèles réellement appelés pendant une session.
- Les changements de modèle susceptibles d’empêcher la réutilisation du cache.
- Le préchauffage du cache, lorsqu’il apparaît dans les coûts de session.
- Les choix de stockage de Pi Durable et leur impact sur la fiabilité.
- Les éventuels frais des fournisseurs de modèles, à distinguer des frais de licence de Pi.
Le bon indicateur n’est donc pas seulement le prix affiché pour un modèle. C’est le coût des modèles utilisés, du routage et des opérations de cache dans votre usage réel, en gardant Pi Durable dans une analyse séparée.
Comment évaluer le coût réel de Pi ?
Pi ne facture ni abonnement ni licence, mais son usage peut générer des coûts chez les fournisseurs d’API. Pour évaluer la dépense, je prends en compte les requêtes aux modèles, les appels spécialisés et les opérations de cache. Le mode code peut réduire les jetons transmis en traitant les résultats avec JavaScript, mais le gain observé dans un test ne se généralise pas automatiquement. Les modèles virtuels offrent une combinaison de modèles, au prix d’un routage à configurer et à régler. Enfin, Pi Durable reste expérimental et ses choix de stockage affectent la fiabilité. En suivant ces postes séparément, vous pouvez mieux comprendre et maîtriser le coût réel de votre usage de Pi.
FAQ
-
Pi est-il gratuit à télécharger ?
Oui, le logiciel Pi est gratuit à télécharger et à exécuter. Les requêtes aux modèles et certains services utilisés peuvent toutefois être facturés par leurs fournisseurs. -
Qui facture les appels aux modèles utilisés avec Pi ?
Les fournisseurs d’API facturent les requêtes aux modèles. Des appels à des modèles spécialisés et certaines opérations d’infrastructure peuvent aussi contribuer au coût. -
Le mode code rend-il toujours Pi moins cher ?
Non. Il peut réduire les jetons transmis en filtrant et en combinant les résultats des outils avec JavaScript. Le gain dépend de la tâche et de la configuration ; un test a mesuré près de 40 % de jetons de requête en moins dans un cas précis. -
Le cache peut-il augmenter le coût d’une session Pi ?
Oui. Le préchauffage ou le rafraîchissement du cache peut apparaître dans les coûts. Changer de modèle physique pendant une session peut également empêcher la réutilisation du cache. -
Que faut-il savoir sur les modèles virtuels et Pi Durable ?
Les modèles virtuels permettent de combiner plusieurs modèles, mais leur routage doit être configuré et réglé par l’utilisateur. Pi Durable est un paquet expérimental distinct ; ses choix de stockage ont des conséquences sur la fiabilité.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor sur leurs sujets de tracking server-side, d’Analytics Engineering, d’automatisation, d’intégration de l’IA et de SEO/GEO. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.