
Avec une spécification claire, des règles projet courtes et une vraie validation, les agents IA de codage deviennent nettement plus fiables. Le sujet n’est pas de mieux prompter. C’est de leur donner un cadre de travail propre, comme à un dev qui rejoint votre repo.
Pourquoi commencer par une spécification ?
Je ne démarre jamais une tâche sérieuse avec une invite du genre corrige ce bug ou ajoute cette feature. Ça marche parfois sur un petit script, mais sur un vrai projet, c’est le meilleur moyen d’obtenir une correction partielle, trop large, ou pire, un changement qui casse autre chose sans prévenir.
Une spécification donne à l’agent IA une cible stable. Pas une intuition. Pas une conversation floue. Un cadre clair. Et franchement, c’est souvent ce qui fait la différence entre “l’agent m’a fait perdre du temps” et “l’agent m’a sorti une PR propre”.
Quand je prépare une spec, je mets toujours les éléments utiles pour éviter les interprétations :
- Objectif : Ce qu’on veut obtenir, en une phrase simple.
- Périmètre : Ce que l’agent peut modifier, et ce qu’il ne doit pas toucher.
- Fichiers ou zones concernées : Même approximatif, ça aide énormément.
- Contraintes techniques : Framework, version, style de code, librairies interdites ou imposées.
- Comportements attendus : Ce qui doit se passer dans les cas normaux et les cas limites.
- Critères d’acceptation : Les conditions concrètes pour dire “c’est terminé”.
- Tests à lancer : Unitaires, intégration, lint, build, ce qui compte vraiment.
- Cas à ne pas casser : C’est bête, mais c’est souvent là que l’IA dérape.
Voilà un exemple de fichier SPEC.md que je donne à un agent pour ajouter une validation côté API. C’est simple, mais assez précis pour éviter les modifications hors sujet.
# SPEC.md

# Objectif
Ajouter une validation côté API lors de la création d'un utilisateur.
L'API doit refuser les emails invalides et les mots de passe trop courts.

# Contexte
Le projet utilise Node.js avec Express.
La route concernée est POST /api/users.
La logique actuelle crée l'utilisateur sans validation stricte.

# Fichiers concernés
- src/routes/users.js
- src/services/userService.js
- tests/users.test.js

# Contraintes
- Ne pas ajouter de nouvelle dépendance npm.
- Garder le format de réponse JSON existant.
- Ne pas modifier le schéma de base de données.
- Ne pas changer les routes existantes.

# Comportement attendu
- Si email est absent ou invalide, retourner HTTP 400.
- Si password est absent ou contient moins de 12 caractères, retourner HTTP 400.
- Si les données sont valides, conserver le comportement actuel de création utilisateur.

# Format d'erreur attendu
{
  "error": "VALIDATION_ERROR",
  "details": ["Email invalide", "Mot de passe trop court"]
}

# Tests à ajouter ou mettre à jour
- Tester un email invalide.
- Tester un password trop court.
- Tester plusieurs erreurs en même temps.
- Tester une création valide.

# Critères d'acceptation
- Tous les tests passent.
- npm test passe sans régression.
- Le code reste lisible et cohérent avec le style existant.
- Aucun autre endpoint utilisateur n'est modifié.

# Cas à ne pas casser
- La création utilisateur valide.
- Les tests existants liés à l'authentification.
- Le format des réponses de succès existantes.
Avec ça, l’agent sait où aller, quoi éviter, quoi tester. J’ai vu ça chez un client sur une API interne assez vieille. Avant les specs, chaque correction ouvrait deux nouveaux sujets. Après, les PR générées étaient plus petites, plus faciles à relire, et surtout moins dangereuses.
| Demande vague | Spécification exploitable |
| Corrige la validation des users. | Ajoute une validation email et password sur POST /api/users, sans nouvelle dépendance, avec erreurs HTTP 400 et tests dédiés. |
| Ajoute cette feature. | Décris l’objectif, les fichiers concernés, les contraintes, les critères d’acceptation et les cas à ne pas casser. |
Où mettre les règles du projet ?
Je vois encore trop d’équipes coller les mêmes consignes dans chaque prompt. C’est fragile, ça fatigue tout le monde, et l’agent finit par rater une règle sur deux. Les règles récurrentes doivent vivre dans le dépôt, au même endroit que le code.
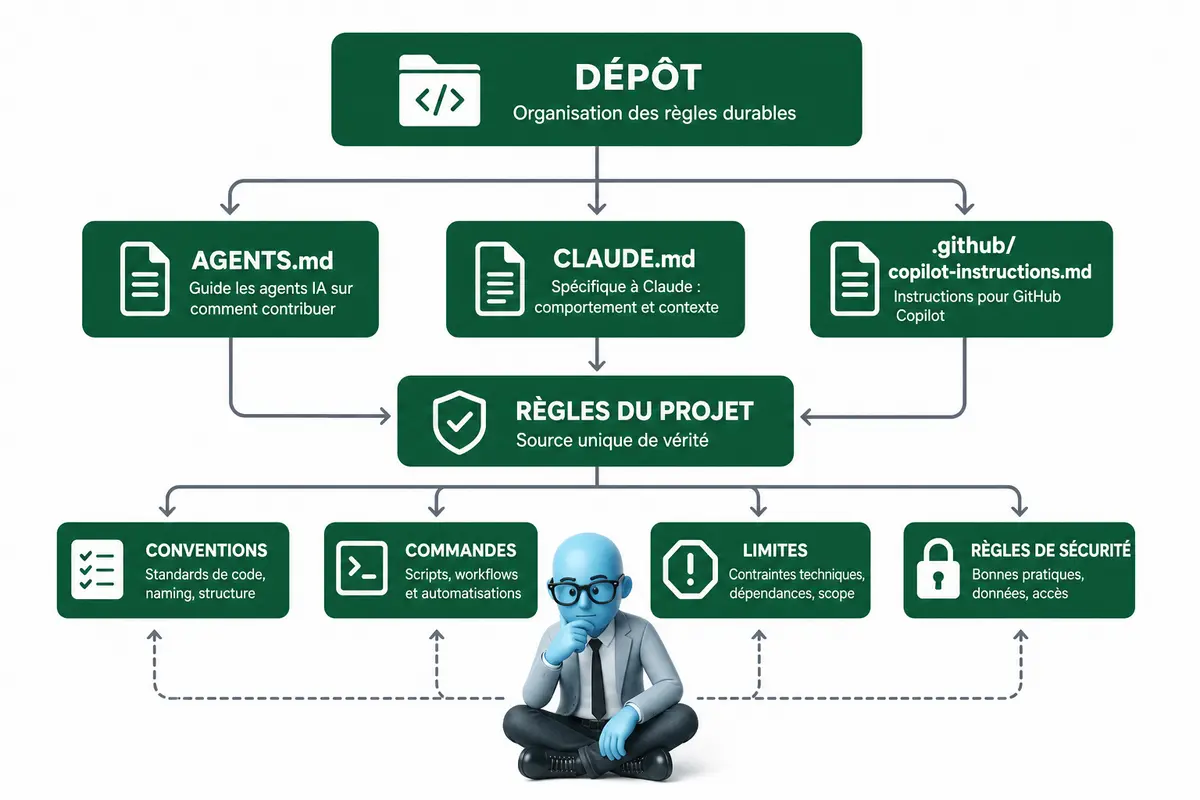
Selon l’outil, je mets ça dans AGENTS.md, CLAUDE.md, ou .github/copilot-instructions.md. Claude Code, GitHub Copilot et les agents IA modernes savent s’appuyer sur ces fichiers pour comprendre le repo. Ça devient leur mémoire opérationnelle : installation, architecture, conventions, commandes de test, formatage, sécurité, et vérifications avant livraison.
Voilà un exemple de AGENTS.md que j’utilise souvent comme base. Le but est simple : éviter de réexpliquer le projet à chaque demande.
# AGENTS.md
# Ce fichier donne les règles stables du projet aux agents IA de codage.

## Projet
# Application web TypeScript avec Node.js, npm et React.
# Le code applicatif est dans src/.
# Les tests sont dans tests/ ou à côté des fichiers en *.test.ts.

## Installation
# Utiliser npm, pas yarn ni pnpm.
npm install

## Commandes utiles
# Lancer le serveur local.
npm run dev

# Vérifier le typage TypeScript.
npm run typecheck

# Lancer les tests.
npm test

# Lancer le lint et le formatage.
npm run lint
npm run format

## Style TypeScript
# Préférer des types explicites sur les fonctions publiques.
# Éviter any sauf justification courte dans un commentaire.
# Garder les fonctions petites et lisibles.
# Ne pas modifier les signatures publiques sans raison claire.

## Limites de modification
# Ne pas réécrire un module entier si une correction locale suffit.
# Ne pas changer la structure des dossiers sans demander.
# Ne pas ajouter de dépendance npm sans expliquer pourquoi.
# Ne pas toucher aux fichiers .env ou secrets.

## Sécurité
# Ne jamais logger de token, mot de passe ou donnée personnelle.
# Valider les entrées utilisateur côté serveur.
# Garder les erreurs utiles, mais sans exposer de détails sensibles.

## Avant Pull Request
# Exécuter npm run typecheck.
# Exécuter npm test.
# Exécuter npm run lint.
# Résumer les changements et les risques éventuels.
Pour GitHub Copilot, je fais souvent une version plus courte dans .github/copilot-instructions.md. C’est moins verbeux, mais ça garde les règles vitales.
# Instructions Copilot

# Utiliser npm uniquement.
# Avant de proposer une livraison, vérifier :
# npm run typecheck
# npm test
# npm run lint

# Écrire du TypeScript strict, éviter any, garder les changements petits.
# Ne pas ajouter de dépendance sans justification.
# Ne jamais modifier les secrets, .env ou variables sensibles.
# Respecter l’architecture existante dans src/.
# Résumer les fichiers modifiés et les impacts avant pull request.
Ce que je mets presque toujours chez un client :
- Les commandes exactes d’installation, test, lint, build et typecheck.
- Les conventions de code, surtout TypeScript, nommage et structure des dossiers.
- Les limites claires sur ce que l’agent peut modifier ou non.
- Les règles de sécurité, secrets, logs, données personnelles.
- La procédure avant pull request, parce que c’est là que les bugs bêtes se rattrapent.
Comment éviter les instructions inutiles ?
Le piège classique avec un agent IA de codage, c’est de vouloir lui écrire une charte de 3 pages. Sois expert. Fais du clean code. Ne fais pas d’erreur. Optimise tout. Ça rassure, mais ça n’aide pas beaucoup.
Ce qui aide vraiment, c’est une instruction actionnable. L’agent doit savoir quoi faire dans ce repo précis, avec vos outils, vos conventions, vos pièges connus. Chez les équipes pressées, je vois souvent le même problème : ce n’est pas le manque d’instructions, c’est le bruit dans les instructions.
Je garde en général ces règles simples :
- Une règle par ligne ou par bloc, pas un paragraphe fourre-tout.
- Supprimer les doublons, parce qu’un agent ne “comprend” pas mieux une règle répétée 4 fois.
- Prioriser les commandes réelles, comme lancer les tests, le lint ou la génération de types.
- Éviter les préférences vagues, du style “fais du code propre”.
- Éviter les contraintes qui se contredisent, comme “modifie le moins possible” et “refactorise toute la feature”.
- Mettre à jour les règles quand le repo change, sinon l’agent suit une carte périmée.
| Avant | Sois un expert TypeScript. Fais du clean code. Ne casse rien. Optimise les performances. Respecte les meilleures pratiques. Écris du code maintenable. Fais attention à la sécurité. Corrige tous les problèmes si tu en vois. |
| Après | Avant de proposer un changement, lis le fichier package.json. Pour valider une modification, utilise pnpm test et pnpm lint. Ne modifie pas le dossier generated. Si tu touches une API publique, mets à jour les tests associés. Préfère une petite modification ciblée à un refactor global. |
Le deuxième exemple est moins ambitieux sur le papier, mais beaucoup plus utile. Il donne des limites, des commandes, des zones à éviter. Bref, du concret.
Pour éviter que le fichier d’instructions devienne une poubelle, je fais une revue mensuelle rapide. Ce petit modèle suffit largement, surtout dans une équipe qui bouge vite :
<ul>
  <li>Les commandes de test, lint et build sont-elles encore valides ?</li>
  <li>Les dossiers interdits ou sensibles existent-ils toujours ?</li>
  <li>Y a-t-il des règles en double ?</li>
  <li>Y a-t-il des règles vagues à remplacer par des consignes concrètes ?</li>
  <li>Y a-t-il des contradictions entre deux instructions ?</li>
  <li>Une règle récente a-t-elle été ajoutée juste pour corriger un cas isolé ?</li>
</ul>
Le bon fichier d’instructions n’est pas long. Il est vivant. Il ressemble moins à une constitution qu’à une note claire laissée à quelqu’un qui doit travailler vite sans casser votre projet.
Quand demander une inspection avant modification ?
Quand la tâche touche autre chose qu’un petit fichier isolé, je préfère que l’agent ralentisse. Pas qu’il code “au feeling”. Je lui demande d’abord d’inspecter le dépôt, parce que le vrai risque, avec un agent IA de codage, c’est qu’il corrige le symptôme sans comprendre le flux.
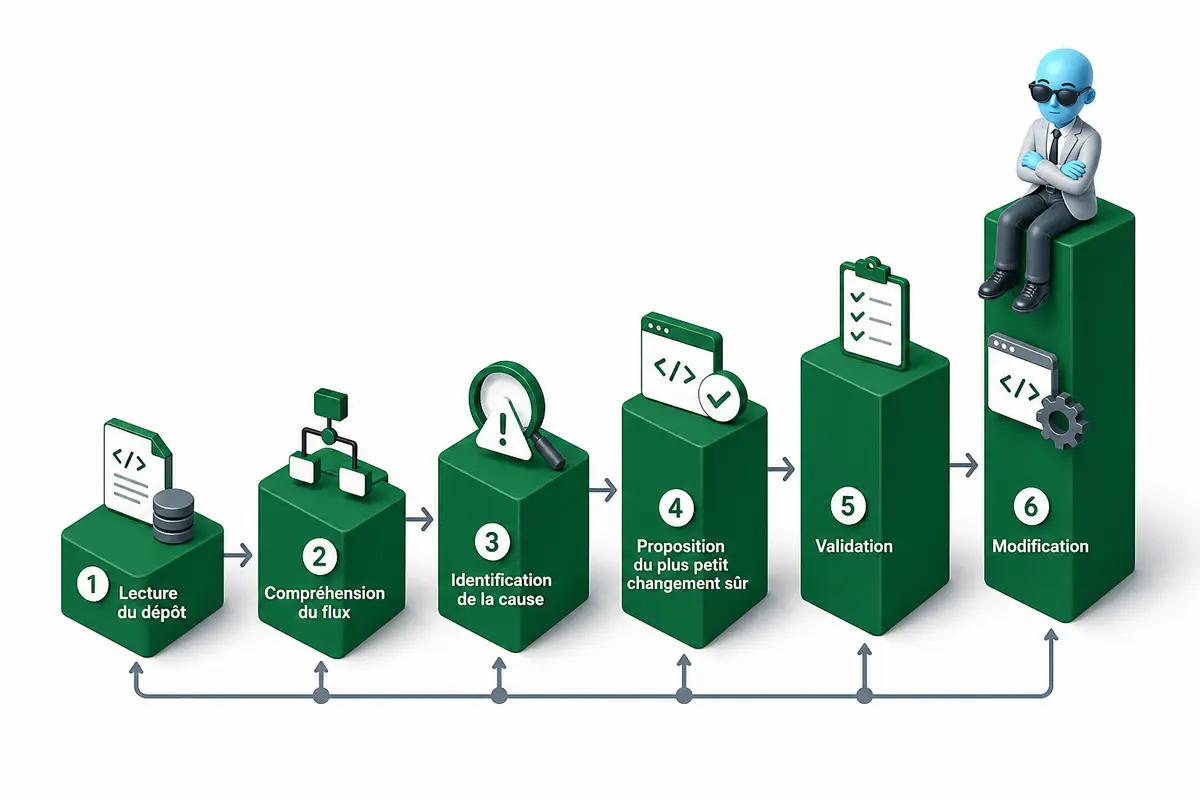
Le workflow que j’attends est simple. L’agent doit lire les fichiers pertinents, comprendre comment la donnée circule, identifier la cause probable, puis proposer le plus petit changement sûr. Petit changement sûr, ça veut dire une modification ciblée, facile à relire, facile à tester, et qui ne réécrit pas la moitié du projet pour se faire plaisir.
- Analyser les fichiers concernés avant toute modification.
- Résumer ce qui a été trouvé, sans roman.
- Citer les fichiers et fonctions impactés.
- Proposer une stratégie courte, avec les risques.
- Attendre ma validation si le changement touche une API, plusieurs modules, ou une logique métier sensible.
- Modifier seulement après validation, puis lancer la validation locale.
Prompt prêt à l’emploi :
Avant d’écrire du code, inspecte le dépôt.

Lis les fichiers pertinents pour comprendre le flux complet.
Résume ce que tu as trouvé.
Cite les fichiers, fonctions ou modules concernés.
Identifie la cause probable du problème.
Propose le plus petit changement sûr.
Si le risque est élevé ou si plusieurs fichiers sont touchés, attends ma validation avant modification.
Ne modifie aucun fichier tant que cette analyse n’est pas terminée.
Je fais ça surtout sur les bugs transverses, les refactors, les changements d’API, les migrations, la dette technique, ou les modifications sur plusieurs fichiers. Sur un client, on avait un bug de calcul dans une facture. L’agent voulait patcher l’affichage. L’inspection a montré que le problème venait d’une règle partagée dans un service métier. Ça a évité une fausse correction.
Pour sécuriser la suite, je garde souvent un script local unique. Il évite les “chez moi ça marche” et donne à l’agent une commande claire à lancer après modification.
#!/usr/bin/env bash

# Arrête le script dès qu'une commande échoue.
set -e

# Affiche chaque étape pour comprendre où ça bloque.
echo "Validation locale en cours..."

# Installe les dépendances si node_modules est absent.
if [ ! -d "node_modules" ]; then
  echo "Installation des dépendances..."
  npm install
fi

# Lance le lint pour détecter les erreurs de style et de qualité.
echo "Lint..."
npm run lint

# Lance les tests automatisés.
echo "Tests..."
npm test

# Lance le build pour vérifier que l'application compile.
echo "Build..."
npm run build

# Confirme que tout est OK.
echo "Validation terminée avec succès."
Cette phase est excessive pour une typo, un renommage local évident, une petite correction de texte, ou un changement isolé dans une config sans effet métier. Là, demander une inspection complète fait perdre du temps.
| Situation | Inspection avant modification ? |
| Bug transverse ou logique métier partagée | Oui |
| Refactor, migration, changement d’API | Oui |
| Modification sur plusieurs fichiers | Oui |
| Typo ou correction de texte | Non |
| Renommage local très limité | Non, sauf doute |
Faut-il toujours demander un plan ?
Je ne demande pas toujours un plan à un agent IA de codage. Ça dépend de la taille du changement. Un plan peut éviter une grosse bêtise, mais il peut aussi transformer une correction de 3 lignes en réunion d’architecture imaginaire.
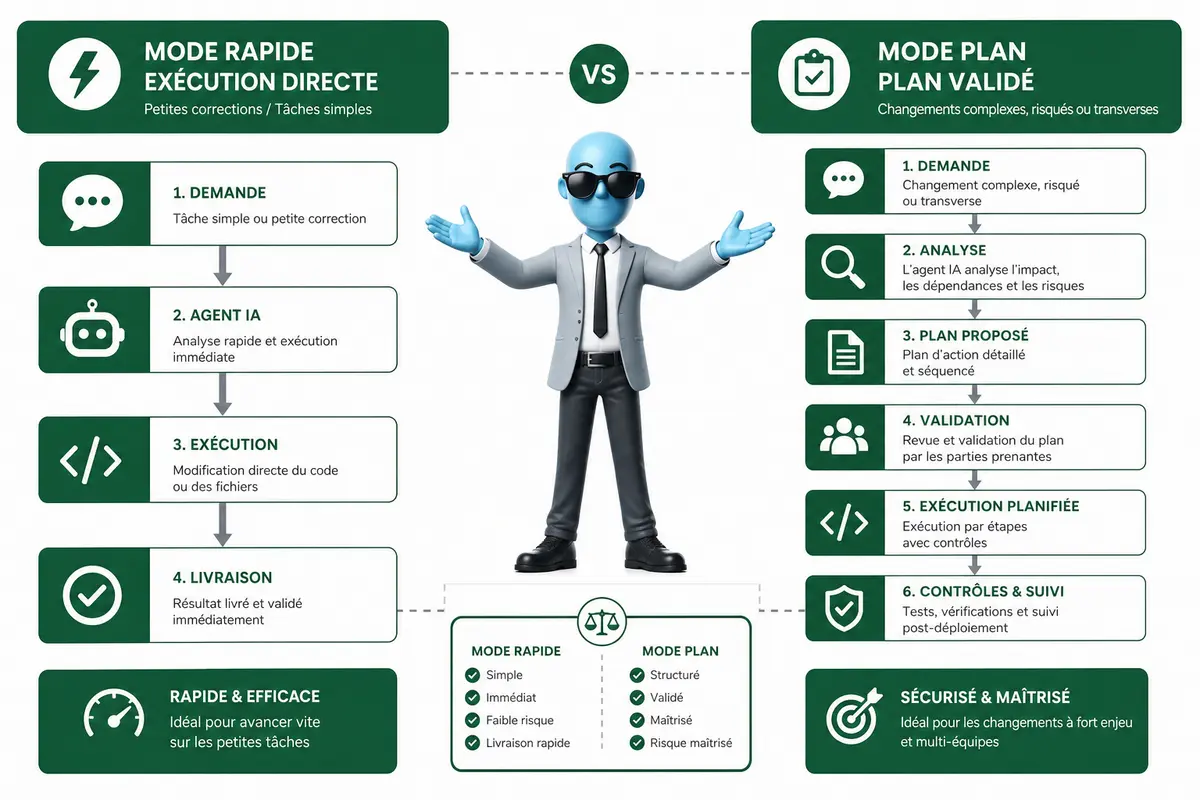
Je demande un plan quand la tâche touche plusieurs fichiers, plusieurs couches techniques, une migration, une logique métier sensible ou des tests importants. Là, je veux voir le raisonnement avant l’exécution. Je veux savoir où l’agent va mettre les mains, ce qu’il risque de casser, et comment il compte vérifier son travail.
Pour une correction minuscule, je préfère une exécution directe avec validation. Typiquement une typo, un bug évident, un import manquant, une condition inversée. Dans ces cas-là, je demande à l’agent de corriger, lancer les checks utiles, puis me résumer le diff, c’est-à-dire la comparaison entre l’ancien code et le nouveau.
Un bon plan doit rester court et utile. Il doit contenir ça :
- Les étapes courtes, dans l’ordre.
- Les fichiers concernés, ou au moins les zones du dépôt.
- Les risques possibles, même s’ils sont faibles.
- Les tests à lancer, unitaires, intégration ou manuels.
- Un rollback possible, c’est-à-dire comment revenir en arrière si ça tourne mal.
Ce qu’il ne doit pas être ? Une dissertation. Une liste interminable. Une nouvelle architecture inventée pour renommer un bouton. J’ai vu ça chez un client, un agent voulait créer un service complet pour corriger un libellé dans une page React. Techniquement propre, complètement inutile.
Voici le prompt que j’utilise quand je veux aller vite :
Mode rapide.
Corrige directement le problème sans proposer de plan.
Limite les changements au strict nécessaire.
Lance les validations pertinentes si elles sont disponibles.
Retourne un résumé court avec les fichiers modifiés, les tests lancés et les risques restants.
Et celui que j’utilise quand le sujet mérite un vrai cadrage :
Mode plan.
Avant de modifier le code, propose un plan court.
Indique les fichiers concernés, les étapes, les risques, les tests à lancer et le rollback possible.
Attends ma validation avant d’implémenter.
Ne propose pas de refonte si elle n’est pas nécessaire.
Avant livraison, je veux souvent cette checklist simple. Le lint, c’est l’analyse automatique du code pour repérer les erreurs de style ou certaines incohérences. Le build, c’est la compilation ou la génération finale de l’application.
| Tests | Les tests utiles ont été lancés et les résultats sont indiqués. |
| Lint | Le contrôle qualité du code passe, ou les erreurs restantes sont expliquées. |
| Build | La compilation passe, si elle est disponible dans le projet. |
| Revue du diff | Les changements sont limités au besoin réel. |
| Résumé final | Les fichiers modifiés, les décisions prises et les risques restants sont listés clairement. |
Le bon réflexe, c’est d’adapter le niveau de préparation à l’impact réel du changement. Une bonne spécification, des règles de dépôt claires, des instructions courtes, une inspection du résultat et un plan adapté quand il faut, c’est ça qui rend les agents IA vraiment utiles.
Et si le vrai sujet était votre workflow ?
Les agents IA de codage ne donnent pas de bons résultats juste parce qu’ils sont puissants. Ils deviennent utiles quand le workflow autour est propre. Je pars d’une spécification claire, je mets les règles durables dans le repo, je garde les instructions courtes, je demande une inspection avant les changements risqués et je réserve la planification aux vraies tâches complexes. C’est simple, mais ça change tout. Vous passez d’un agent qui improvise à un assistant qui travaille dans un cadre. Le bénéfice pour vous est direct : moins de dérives, moins de régressions, plus de code livrable.
FAQ
- Qu’est-ce qu’un agent IA de codage ?
Un agent IA de codage est un assistant capable de comprendre un dépôt, lire plusieurs fichiers, proposer des modifications, écrire du code et parfois exécuter des commandes. Il va plus loin qu’une simple autocomplétion, mais il a besoin d’un cadre clair pour rester fiable. - Pourquoi une spécification améliore les résultats ?
Une spécification fixe l’objectif, le périmètre, les contraintes et les critères d’acceptation. L’agent sait ce qu’il doit faire, ce qu’il ne doit pas toucher et comment vérifier son travail. Ça limite les modifications hors sujet. - À quoi sert un fichier AGENTS.md ou CLAUDE.md ?
Ce fichier centralise les règles du projet : installation, commandes de test, conventions de code, style attendu et vérifications avant livraison. Au lieu de répéter ces règles dans chaque prompt, on les garde dans le dépôt. - Faut-il toujours demander un plan à l’agent IA ?
Pas toujours. Un plan est utile pour une tâche complexe, risquée ou transverse. Pour une petite correction, il peut ralentir inutilement le travail. Le bon réflexe, c’est d’adapter le niveau de préparation au niveau de risque. - Comment vérifier le travail d’un agent IA de codage ?
Je vérifie le diff, je lance les tests, le lint, le build et je demande un résumé des changements. Pour les tâches sensibles, je préfère aussi que l’agent explique les fichiers modifiés et les risques restants avant validation.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne les équipes sur le tracking server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et le SEO/GEO. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer vos usages IA, automatiser vos workflows ou fiabiliser vos projets data, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.