
Kolibri-1 s’évalue en tenant compte de ses paramètres actifs, pas seulement de ses 78 milliards de paramètres totaux. Je détaille les comparaisons pertinentes, les limites des scores disponibles, son architecture MoE et ses capacités en allemand et en anglais.
Qu’est-ce que Kolibri-1 ?
Kolibri-1 est un modèle de raisonnement open-weight développé par Aleph Alpha, spécialisé en allemand et en anglais, et publié sous licence Apache 2.0. Ses poids sont accessibles sous cette licence. Le modèle prend en charge plusieurs niveaux d’effort de raisonnement et l’appel d’outils au format Hermes.
Les chiffres de paramètres demandent une lecture précise. Kolibri-1 compte 78 milliards de paramètres au total, mais seulement 3,46 milliards sont activés pour chaque jeton traité. Le premier chiffre décrit la taille totale du modèle. Le second indique la part mobilisée pour produire un jeton donné. Ces valeurs ne sont donc pas contradictoires : elles correspondent à deux mesures différentes.
Kolibri-1 propose quatre niveaux d’effort de raisonnement :
- Désactivé.
- Faible.
- Moyen.
- Élevé.
Ce réglage permet de choisir l’effort de raisonnement demandé au modèle. Il ne faut pas le confondre avec une mesure de qualité : les performances se vérifient séparément, sur des tâches adaptées à votre usage.
Le tokenizer de Kolibri-1 est adapté à la morphologie allemande. Un tokenizer convertit le texte en unités que le modèle peut traiter. Cette adaptation concerne le découpage des mots allemands, qui peuvent notamment être composés ou fléchis. Elle ne suffit pas, à elle seule, à établir la qualité du modèle en allemand : celle-ci doit être évaluée sur des données représentatives.
Pour interpréter les benchmarks, gardez donc en tête les caractéristiques distinctives du modèle : sa spécialisation linguistique, son nombre total de paramètres, le nombre activé par jeton et le niveau d’effort utilisé. Comparer des résultats sans tenir compte de ces réglages peut conduire à des conclusions trompeuses.
Quels modèles comparer à Kolibri-1 ?
Je compare Kolibri-1 à des modèles regroupés par nombre de paramètres actifs. Pour les architectures à experts, c’est le nombre de paramètres mobilisés pour traiter chaque jeton — et non le nombre total de paramètres — qui donne le repère le plus utile sur le calcul effectué à l’inférence. Cette approche rapproche les modèles sans prétendre qu’ils sont équivalents en architecture ou en entraînement.
Le groupe le plus directement comparable rassemble les modèles autour de 3 milliards de paramètres actifs :
- Qwen3.5 35B-A3B.
- GLM-4.7 Flash 30B-A3B.
- Nemotron 3 Nano 30B-A3B.
J’ajoute Kolibri Origin comme référence interne : il permet de situer Kolibri-1 par rapport à un point de contrôle antérieur, avec un contexte de développement plus proche que celui des modèles externes. Je conserve aussi les groupes de 4 à 6 milliards et de 12 milliards de paramètres actifs, en y plaçant les modèles prévus dans le protocole. Les noms et configurations exacts doivent être confirmés avant toute comparaison ; je ne les déduis pas des seules catégories.
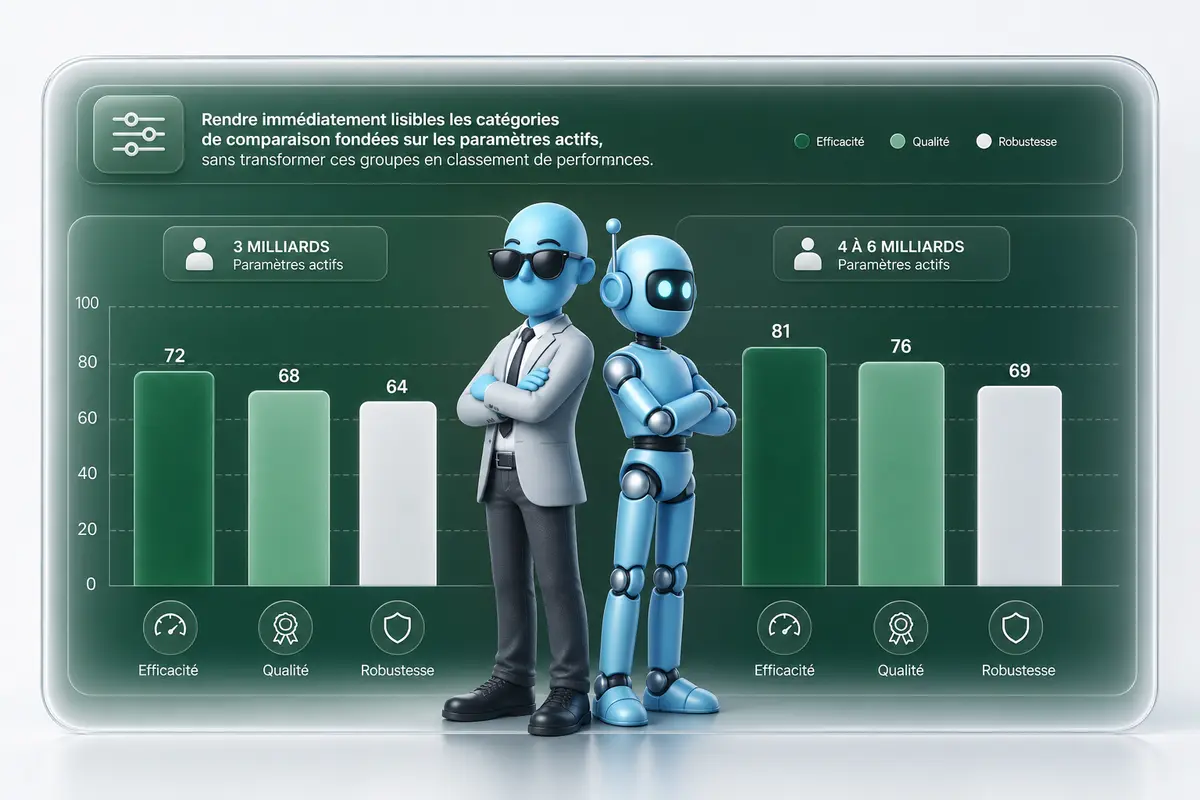
Les modèles denses de 27 et 70 milliards de paramètres complètent le cadre. Ils apportent un repère de capacité à plus grande échelle, mais leur coût de calcul par jeton n’est pas directement comparable à celui d’un modèle à experts de taille totale similaire. Les résultats doivent donc rester séparés par catégorie. Sans mesures chiffrées vérifiées, je ne construis ni classement ni score composite.
Ces groupes répondent à des questions différentes :
| Catégorie | Intérêt de comparaison |
| Environ 3 milliards actifs | Comparer Kolibri-1 à des modèles proches en calcul par jeton. |
| 4 à 6 milliards et 12 milliards actifs | Observer l’effet d’une enveloppe de calcul supérieure. |
| Denses de 27 et 70 milliards | Fournir des repères de modèles denses à plus grande échelle. |
| Kolibri Origin | Mesurer l’évolution par rapport à une référence interne. |
Pourquoi séparer les modèles MoE et denses ?
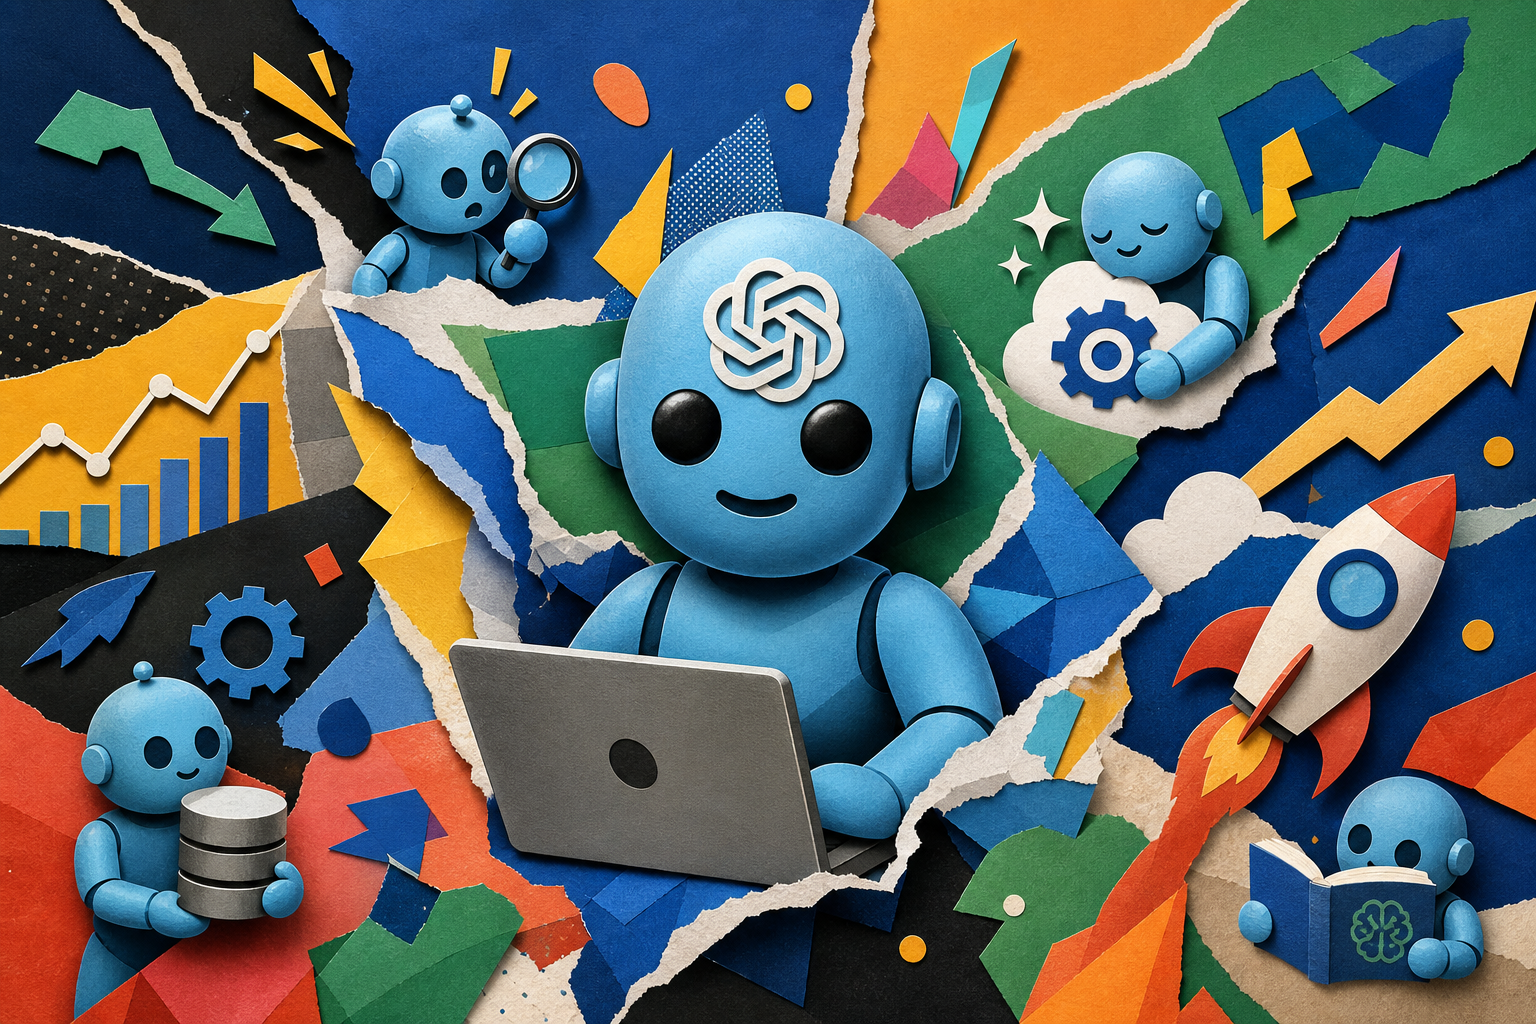
Il faut séparer les modèles MoE des modèles denses, car leur nombre total de paramètres ne décrit pas de la même façon le calcul effectué à l’inférence. Un modèle dense mobilise ses paramètres à chaque passage des jetons dans le réseau. Un modèle MoE, ou « mélange d’experts », répartit ses paramètres entre plusieurs sous-réseaux spécialisés et n’en active qu’une partie pour chaque jeton, via un mécanisme de routage.
Kolibri-1 compte 78 milliards de paramètres au total, mais seulement 3,46 milliards sont actifs par jeton. Ses poids occupent environ 78 Go en FP8, un format de représentation numérique sur 8 bits. Cette taille correspond au stockage des poids, pas à la mémoire totale nécessaire pour exécuter le modèle : le cache des séquences, les activations et les surcoûts d’exécution s’ajoutent.
Comparer directement Kolibri-1 à un modèle dense peut donc fausser l’interprétation du coût d’inférence. Le total des paramètres renseigne surtout sur la capacité du modèle et l’espace nécessaire pour stocker ses poids. Le nombre de paramètres actifs donne une indication plus pertinente du calcul par jeton, sans suffire à lui seul : le routage, la taille des lots, la longueur des séquences, la bande passante mémoire et l’optimisation des kernels influencent aussi le temps et le coût d’exécution.
Pour lire les benchmarks, il faut distinguer deux références dans chaque groupe évalué : le meilleur résultat global, tous types d’architectures confondus, et le meilleur résultat parmi les seuls modèles MoE. La première situe Kolibri-1 face à l’ensemble des modèles comparés. La seconde permet de le comparer à des architectures dont le fonctionnement et les compromis d’inférence sont plus proches.
Sans les scores détaillés et le protocole de mesure, on ne peut pas conclure que Kolibri-1 est plus performant ou moins coûteux qu’un autre modèle. La séparation des catégories rend la comparaison plus lisible ; elle ne remplace pas l’analyse des métriques, du matériel et des conditions de test.
Que sait-on de son architecture et de son entraînement ?
Les informations disponibles décrivent plusieurs éléments de l’architecture et de l’entraînement de Kolibri-1, mais elles ne suffisent pas à reconstituer le modèle dans son ensemble. Les détails complémentaires ne sont pas documentés dans les éléments fournis.
Architecture documentée : Kolibri-1 est présenté comme un Transformer à mélange d’experts, ou MoE (Mixture of Experts), composé de 50 couches. Le rapport entre les deux mécanismes d’attention annoncés est de 4:1 : attention à fenêtre glissante (SWA), qui limite l’attention à une fenêtre de contexte, et attention à requêtes groupées (GQA), qui regroupe les requêtes pour l’attention.
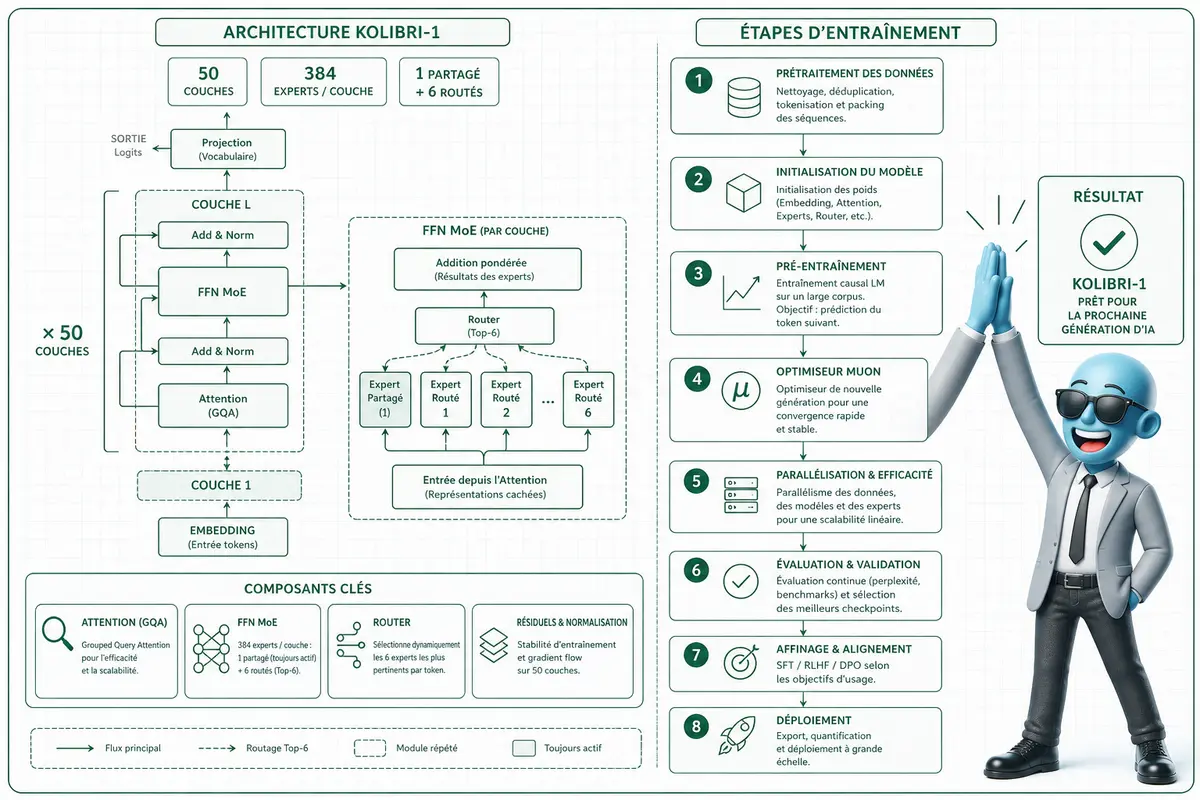
Chaque couche comprend 384 experts. Le routage annoncé mobilise un expert partagé et six experts routés par jeton. L’équilibrage des experts repose sur Exact Quantile Balancing. Muon est indiqué comme optimiseur, c’est-à-dire l’algorithme utilisé pour ajuster les paramètres du modèle pendant l’entraînement.
| Élément | Information disponible |
| Architecture | Transformer MoE de 50 couches, avec un rapport SWA/GQA de 4:1. |
| Experts | 384 par couche, un expert partagé et six experts routés par jeton. |
| Entraînement | 20 000 milliards de jetons bilingues, puis une phase principale sur 768 GPU NVIDIA B200 pendant environ trois semaines. |
| Optimisation | Muon et Exact Quantile Balancing sont mentionnés. |
| Détails indisponibles | Les autres caractéristiques de l’architecture et les paramètres détaillés de l’entraînement ne sont pas précisés. |
Les données publiées ne précisent pas davantage la composition des corpus bilingues, le calendrier exact entre les jetons et la phase principale, ni les réglages de l’entraînement. Elles ne donnent pas non plus suffisamment de détails pour déterminer l’implémentation complète des mécanismes d’attention ou du routage des experts. Ces limites comptent lorsqu’on évalue des benchmarks : les informations disponibles décrivent des choix techniques, mais ne permettent pas d’en déduire les performances de Kolibri-1 ni d’attribuer un effet causal à l’un de ces choix.
Comment interpréter les résultats disponibles ?
Les scores exacts des benchmarks de Kolibri-1 ne sont pas disponibles. Il est donc impossible d’établir un classement fiable ou de quantifier son écart avec des modèles concurrents.
Les informations documentées permettent de situer le modèle, pas de conclure sur ses performances. Je commencerais par comparer le nombre de paramètres actifs, c’est-à-dire ceux mobilisés pour produire une réponse. Ce repère aide à rapprocher des modèles de capacité comparable, mais ne prédit pas à lui seul leurs résultats.
Je distinguerais ensuite l’architecture. Un modèle MoE (« mixture of experts », ou mélange d’experts) active une partie de ses experts selon la requête. Un modèle dense mobilise l’ensemble de ses paramètres. Les comparer sans tenir compte de cette différence peut fausser l’interprétation de leur taille et de leur coût d’exécution.
Je prendrais aussi en compte la spécialisation allemand-anglais annoncée, puis les capacités de raisonnement et d’appel d’outils. Ces éléments décrivent le positionnement de Kolibri-1 et les usages visés. Ils ne démontrent pas, à eux seuls, une supériorité sur un benchmark donné.
Évaluer les performances exige les résultats détaillés, mais aussi les conditions de test. Sans elles, deux scores peuvent porter sur des tâches, des versions de modèles ou des protocoles différents. Une comparaison exploitable doit préciser les benchmarks et leurs métriques, les versions évaluées, les paramètres d’inférence et le protocole de test.
| Information publiée | Ce qu’elle permet d’interpréter |
| Paramètres actifs et architecture | La catégorie de modèles à comparer, sans conclure sur le classement. |
| Langues, raisonnement et appels d’outils | Les capacités et les usages ciblés. |
| Scores, métriques et conditions de test | Les performances mesurées et les écarts comparatifs. |
Que retenir avant de comparer Kolibri-1 ?
Kolibri-1 est un modèle MoE open-weight de 78 milliards de paramètres, dont 3,46 milliards sont activés par jeton. Ses benchmarks doivent être lus en distinguant les modèles selon leurs paramètres actifs et en séparant MoE et modèles denses, notamment pour éviter de confondre capacité totale et calcul à l’inférence. Sa spécialisation allemand-anglais, ses niveaux d’effort de raisonnement et l’appel d’outils complètent son profil. Son architecture et son entraînement sont documentés en partie, mais les scores précis ne sont pas disponibles ici. Il n’est donc pas possible de conclure à un classement. En appliquant ces repères, vous pourrez évaluer les comparaisons sans confondre performances et coûts de calcul.
FAQ
-
Combien de paramètres Kolibri-1 active-t-il par jeton ?
Kolibri-1 compte 78 milliards de paramètres au total et en active 3,46 milliards par jeton. -
Quels modèles MoE sont comparés à Kolibri-1 ?
Les modèles cités dans la catégorie proche de 3 milliards de paramètres actifs sont Qwen3.5 35B-A3B, GLM-4.7 Flash 30B-A3B et Nemotron 3 Nano 30B-A3B. Kolibri Origin apparaît aussi comme référence interne ou ancien point de contrôle. -
Pourquoi comparer les paramètres actifs ?
Les paramètres actifs donnent un repère sur le calcul mobilisé par jeton. Ils aident à comparer les modèles MoE entre eux sans assimiler leur nombre total de paramètres à leur coût de calcul à l’inférence. -
Quelles langues Kolibri-1 privilégie-t-il ?
Kolibri-1 est conçu pour l’allemand et l’anglais. Son tokenizer est adapté à la morphologie allemande. -
Les scores précis des benchmarks sont-ils disponibles ?
Non, les informations disponibles ne donnent pas les scores exacts. Elles ne permettent donc pas d’établir un classement chiffré fiable entre Kolibri-1 et ses concurrents.
A propos de l’auteur
Je suis Franck Scandolera, spécialiste en data engineering et en automatisation IA. J’analyse les architectures et les conditions d’évaluation des modèles pour aider les équipes à choisir des solutions adaptées à leurs usages métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.