
Naive-N0.5-Flash associe une architecture MoE de 309 milliards de paramètres à une attention hybride pour gérer un million de tokens de contexte. Voici comment fonctionnent son attention SWA-DSA, ses paramètres actifs et sa pile d’inférence, avec les limites à garder en tête.
Qu’est-ce que Naive-N0.5-Flash ?
Naive-N0.5-Flash est un modèle de langage open-weight de NaiveAI, basé sur MiMo-V2.5 de Xiaomi et conçu pour le codage et la recherche en IA. Ses poids sont publiés sous licence MIT. Le modèle totalise 309 milliards de paramètres, dont 15,5 milliards sont activés pour chaque token traité, et dispose d’une fenêtre de contexte native d’un million de tokens.
Ces chiffres décrivent des capacités et des choix d’architecture, pas une garantie de qualité, de vitesse ou de précision. Les 309 milliards correspondent à la taille totale du modèle ; les 15,5 milliards indiquent la part mobilisée par token. Cette activation partielle peut limiter le calcul nécessaire par rapport à l’activation de tous les paramètres, mais ne suffit pas à établir le coût ou la latence réels. La licence MIT autorise un usage étendu des poids, sous réserve de ses conditions ; elle ne garantit pas, à elle seule, l’accès aux données d’entraînement ou à l’ensemble du code.
Une fenêtre d’un million de tokens permet de fournir au modèle des entrées très longues, par exemple un grand corpus ou une base de code. Elle ne signifie pas que chaque token sera traité au même coût, ni que le modèle exploitera parfaitement tout le contexte. C’est là qu’intervient l’attention hybride SWA-DSA : SWA désigne l’attention à fenêtre glissante, et DSA l’attention clairsemée dynamique. Cette combinaison est le mécanisme annoncé pour traiter le contexte étendu sans appliquer une attention dense uniforme à l’ensemble des tokens.
La suite détaille l’architecture derrière cette attention hybride, puis le coût réel d’inférence : ce que le modèle mobilise en calcul et en mémoire lors de son utilisation. Ces éléments sont nécessaires pour évaluer son intérêt dans un environnement de production.
Comment l’attention SWA-DSA gère-t-elle un million de tokens ?
Naive-N0.5-Flash combine une attention locale SWA et une attention creuse DSA, au lieu d’appliquer une attention complète à chaque couche. Ce choix permet de traiter de très longs contextes, jusqu’à un million de tokens, sans faire porter le calcul d’attention principal sur tout l’historique à chaque couche.
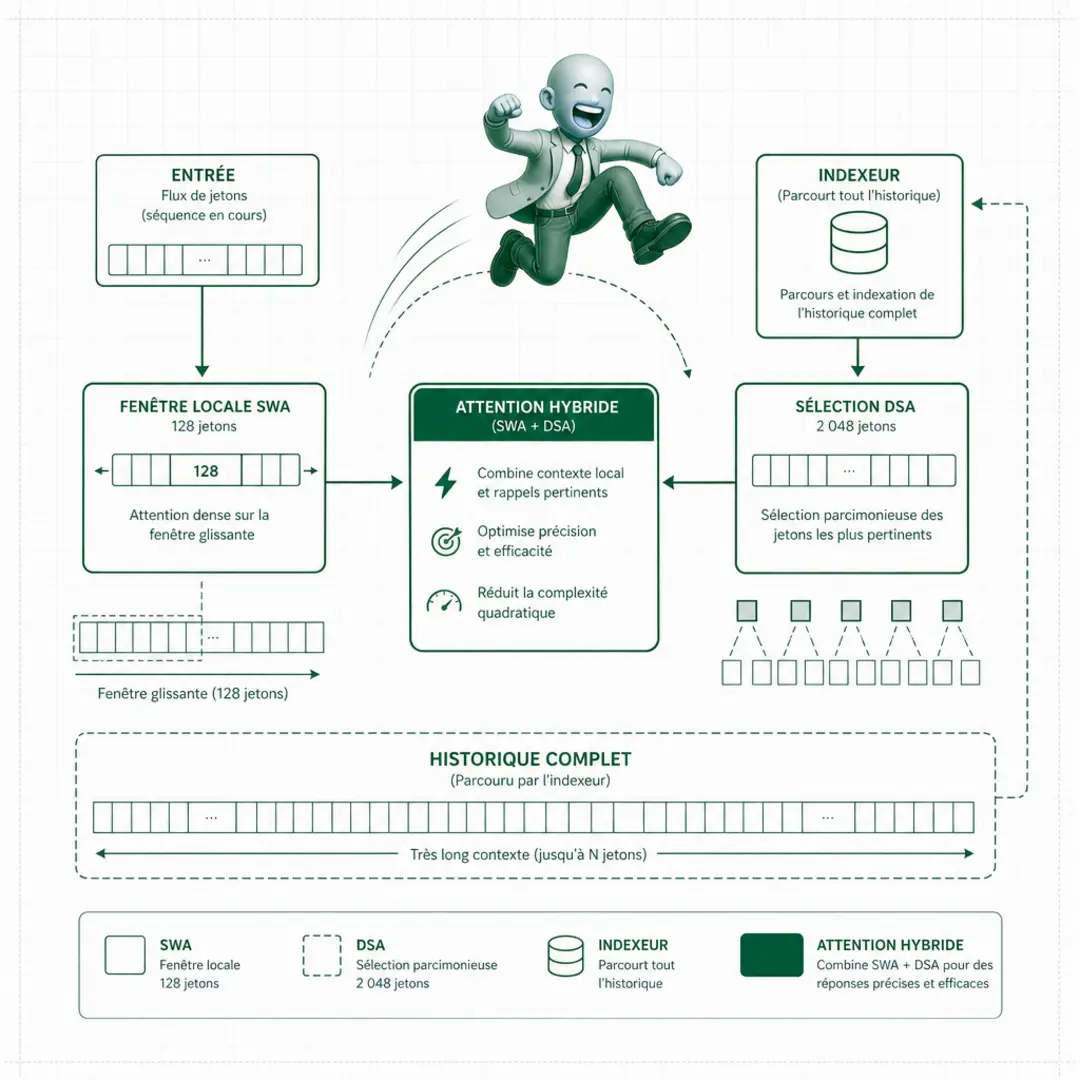
L’attention complète devient coûteuse en calcul et en bande passante mémoire lorsque le contexte s’allonge. SWA et DSA répartissent cette charge différemment :
- SWA limite l’attention à une fenêtre locale de 128 tokens. Chaque couche SWA traite donc le contexte proche plutôt que l’historique entier.
- DSA utilise un indexeur léger pour évaluer l’historique complet, puis sélectionner jusqu’à 2 048 tokens. Le réseau principal calcule ensuite l’attention sur ces tokens sélectionnés.
La sélection DSA réduit le calcul d’attention effectué par le réseau principal, mais elle ne fait pas disparaître les coûts d’accès à l’historique. L’indexeur parcourt toujours tous les tokens, et le cache KV complet reste en mémoire. Le cache KV stocke les clés et les valeurs produites par les couches d’attention afin de les réutiliser pendant la génération.
Les 48 couches sont organisées en huit modules de six couches. Un module comprend généralement cinq couches SWA suivies d’une couche DSA ; une couche DSA supplémentaire est placée au début. Les deux types d’attention utilisent des biais de puits, qui fournissent des positions d’attention de référence. La DSA dispose de quatre groupes KV, tandis que son indexeur utilise 16 têtes.
Cette architecture combine une attention locale fréquente et une attention globale sélective. Elle permet de maîtriser le calcul du réseau principal sur les longs contextes, tout en conservant le coût de l’indexation et du cache KV. C’est cette organisation qui accompagne l’entraînement du modèle sur 3,25 billions de tokens.
Pourquoi le modèle n’active-t-il que 15,5 milliards de paramètres ?
Naive-N0.5-Flash active 15,5 milliards de paramètres par token sur un total de 309 milliards. Ce fonctionnement repose sur une architecture MoE, ou « mixture of experts » : le modèle possède une grande capacité totale, mais seule une partie de ses paramètres est mobilisée pour produire chaque token.
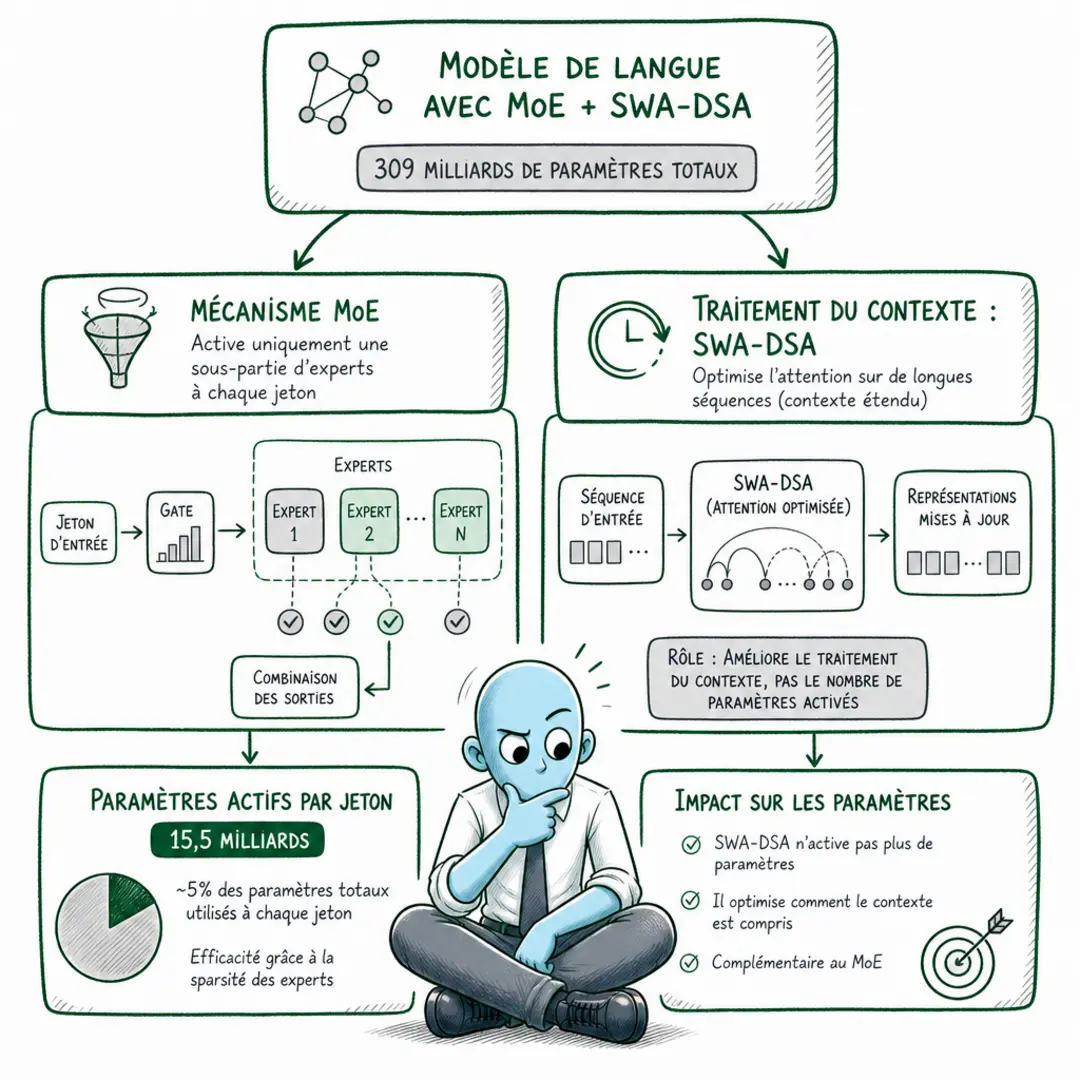
La capacité totale correspond à l’ensemble des paramètres disponibles dans le modèle. Les paramètres actifs désignent ceux qui contribuent effectivement au calcul pour un token donné. Les 309 milliards décrivent donc la taille globale du modèle, tandis que les 15,5 milliards décrivent la quantité activée à chaque étape de génération. Ces chiffres ne signifient pas que le modèle utilise toujours les mêmes paramètres.
L’objectif est de conserver une capacité élevée sans payer, à chaque token, le coût de calcul associé à l’activation de l’ensemble des 309 milliards de paramètres. L’inférence peut ainsi viser un coût proche de celui d’un modèle dense beaucoup plus petit, où les paramètres sont généralement mobilisés pour chaque token. C’est un objectif architectural, pas une garantie de latence ou de coût réel. Les résultats dépendent notamment du matériel, des logiciels d’exécution, de la taille des lots et de la longueur des séquences.
Cette parcimonie des paramètres ne doit pas être confondue avec le traitement du contexte. Le lien avec SWA-DSA porte sur deux enjeux distincts :
- MoE : limiter les paramètres mobilisés pour chaque token, tout en conservant une capacité totale importante.
- SWA-DSA : traiter l’attention et le contexte, c’est-à-dire la manière dont le modèle exploite les informations précédentes pour produire la suite.
Les deux mécanismes peuvent contribuer à l’efficacité, mais ils n’agissent pas au même niveau. MoE concerne l’activation des paramètres ; SWA-DSA concerne le calcul lié au contexte. Les 15,5 milliards actifs ne suffisent donc pas, à eux seuls, à déduire la latence ou le coût complet d’une génération.
Que sait-on de l’inférence, des performances et du prix ?
NaiveRT combine fusion de méga-noyaux, lancement dépendant programmatique et décodage spéculatif ; le débit annoncé peut atteindre 2 000 tokens par seconde dans le mode le plus rapide. Cette valeur décrit un mode d’exécution précis, pas une performance garantie pour toute configuration, toute longueur de contexte ou toute requête.
Ces techniques ciblent le coût de l’inférence, c’est-à-dire la génération des réponses à partir d’une requête. La fusion de méga-noyaux regroupe plusieurs opérations GPU dans un même noyau afin de limiter les lancements séparés. Le lancement dépendant programmatique permet d’enchaîner des opérations sans repasser systématiquement par le processeur. Le décodage spéculatif génère des tokens candidats pour accélérer la production lorsque ces candidats sont validés. Le gain réel dépend toutefois de la charge, du matériel et du mode utilisé.
La fiche du modèle présente des résultats sur des tests de programmation, d’agents et de recherche en IA, en comparaison avec plusieurs autres modèles. Ces éléments donnent des repères sur les tâches évaluées, mais ils ne suffisent pas à établir un classement général. Aucun score isolé ne permet de prédire les performances sur vos propres requêtes.
Les tarifs fournis distinguent trois catégories de tokens facturés :
- tokens entrants : 0,10 dollar par million de tokens.
- tokens sortants : 0,40 dollar par million de tokens.
- tokens mis en cache : 0,01 dollar par million de tokens.
Le prix dépend donc de la catégorie de tokens comptabilisée. Ces tarifs ne permettent pas, à eux seuls, d’extrapoler un coût d’usage sans connaître la répartition des tokens entrants, sortants et mis en cache. Pour évaluer le modèle, considérez ensemble la taille du contexte, le mécanisme d’attention, le nombre de paramètres actifs, le débit annoncé et les tarifs. Un débit élevé ne compense pas nécessairement un contexte inadapté ou un coût qui ne correspond pas à votre profil d’usage.
Est-ce le bon modèle pour votre usage ?
Naive-N0.5-Flash combine une fenêtre native d’un million de tokens, 309 milliards de paramètres au total et 15,5 milliards activés par token. Son attention SWA-DSA limite le calcul d’attention du réseau principal, mais l’indexeur parcourt tout l’historique et le cache KV complet reste en mémoire. Sa pile NaiveRT annonce jusqu’à 2 000 tokens par seconde dans son mode le plus rapide ; les tarifs distinguent tokens entrants, sortants et mis en cache. Pour décider, confrontez ces caractéristiques à vos tâches de codage, d’agents ou de recherche, puis vérifiez les performances sur vos propres requêtes. Vous pourrez ainsi choisir un modèle adapté à vos contraintes de contexte, de débit et de coût.
FAQ
- Quelle est la taille de la fenêtre de contexte de Naive-N0.5-Flash ?
Sa fenêtre de contexte native atteint un million de tokens. - Combien de paramètres sont activés par token ?
Le modèle compte 309 milliards de paramètres au total, dont 15,5 milliards sont activés par token. - Comment fonctionne son attention hybride ?
La SWA traite une fenêtre locale de 128 tokens. La DSA sélectionne jusqu’à 2 048 tokens dans l’historique pour le calcul d’attention du réseau principal, à l’aide d’un indexeur léger. - La DSA évite-t-elle de parcourir tout le contexte ?
Non. L’indexeur parcourt l’historique complet et le cache KV complet reste en mémoire. La sélection réduit le calcul d’attention du réseau principal, mais ne supprime pas ces coûts. - Quels sont les tarifs de l’API ?
Les tarifs indiqués sont de 0,10 dollar par million de tokens entrants, 0,40 dollar par million de tokens sortants et 0,01 dollar par million de tokens mis en cache.
A propos de l’auteur
Franck Scandolera est expert en data engineering et en automatisation IA. Il analyse les architectures de modèles et leurs usages dans les workflows agentiques et les applications métier intelligentes.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.