
Gemini 4 Argon peut coûter moins cher sur certaines tâches, mais son prix promotionnel ne suffit pas à garantir une facture inférieure. Le tarif standard, le volume de tokens générés et le type d’évaluation changent la comparaison. Voici comment lire les chiffres avant de budgéter son usage.
Qu’est-ce que Gemini 4 Argon ?
Gemini 4 Argon est présenté comme un modèle avancé en concurrence avec Opus 5.5, Sonnet 5.5, GPT 6 et Astra. Cette présentation le positionne sur un marché où le prix compte, mais elle ne permet pas, à elle seule, de conclure qu’il coûte moins cher que ses concurrents.
Les informations disponibles décrivent une ouverture initiale à certains partenaires de cybersécurité. Une disponibilité plus large est ensuite annoncée pour les clients payants de l’API et les abonnés Google AI Ultra. Il faut distinguer ces annonces d’une disponibilité effectivement confirmée : aucune date publique n’est indiquée pour cette ouverture élargie.
Je ne peux donc pas déduire de ces éléments qui peut utiliser le modèle aujourd’hui, ni à quelles conditions précises. Ils ne précisent pas non plus les tarifs de l’API ou de l’abonnement Google AI Ultra. Sans prix vérifiés et sans conditions d’accès détaillées, comparer Gemini 4 Argon à Opus 5.5, Sonnet 5.5, GPT 6 ou Astra serait prématuré.
L’accès au modèle ne suffit pas à estimer son coût réel. Celui-ci dépend du tarif appliqué, mais aussi de votre usage : volume de requêtes, quantité de données traitées et fréquence d’utilisation. Tant que les prix et les modalités d’accès ne sont pas publiquement confirmés, il est impossible d’affirmer que Gemini 4 Argon est moins cher que ses concurrents. Pour une comparaison exploitable, il faudra rapprocher les tarifs officiels d’un scénario d’usage identique.
Quels sont les tarifs de Gemini 4 Argon ?
Le tarif de lancement de Gemini 4 Argon est de 2 $ par million de tokens en entrée et de 10 $ par million de tokens en sortie. Les tokens sont les unités de texte facturées par le modèle. Les entrées mises en cache bénéficient d’une réduction de 95 % par rapport au tarif d’entrée de lancement.
Ces prix sont promotionnels. Google indique qu’ils doivent doubler après une période dont la date de fin n’est pas précisée. Pour établir un budget qui ne repose pas sur cette promotion, je retiens donc les tarifs standards suivants :
| Type de token | Tarif de lancement | Tarif standard à retenir |
| Entrée non mise en cache | 2 $ / million | 4 $ / million |
| Sortie | 10 $ / million | 20 $ / million |
| Entrée mise en cache | 95 % de réduction sur le tarif d’entrée de lancement | Non précisé ici |
Une entrée correspond aux tokens transmis au modèle, par exemple dans une requête ou un contexte. Une sortie correspond aux tokens générés par le modèle. Une entrée mise en cache est une entrée réutilisée depuis le cache ; sa tarification est distincte de celle d’une entrée non mise en cache.
Avec la réduction annoncée, le coût d’une entrée mise en cache au tarif de lancement revient à 0,10 $ par million de tokens. Je ne projette pas ce montant sur le tarif standard : les informations disponibles ne précisent pas son évolution après la période promotionnelle.
La distinction compte dans une estimation réelle. Si vos appels génèrent beaucoup de texte, le tarif de sortie pèse davantage que celui des entrées. Et si votre budget repose uniquement sur les prix promotionnels, il risque de sous-estimer le coût futur lorsque les tarifs annoncés doubleront.
Combien coûte Argon face aux autres modèles ?
Argon peut être compétitif, mais son classement dépend de l’indice retenu et du type de tâche mesuré. Les estimations d’Artificial Analysis le placent à environ 1,99 $ par tâche au tarif promotionnel, contre 3,26 $ pour Astra. GPT 6.1 Solo ressort à environ 0,72 $ par tâche, avec un score légèrement inférieur à celui d’Argon.
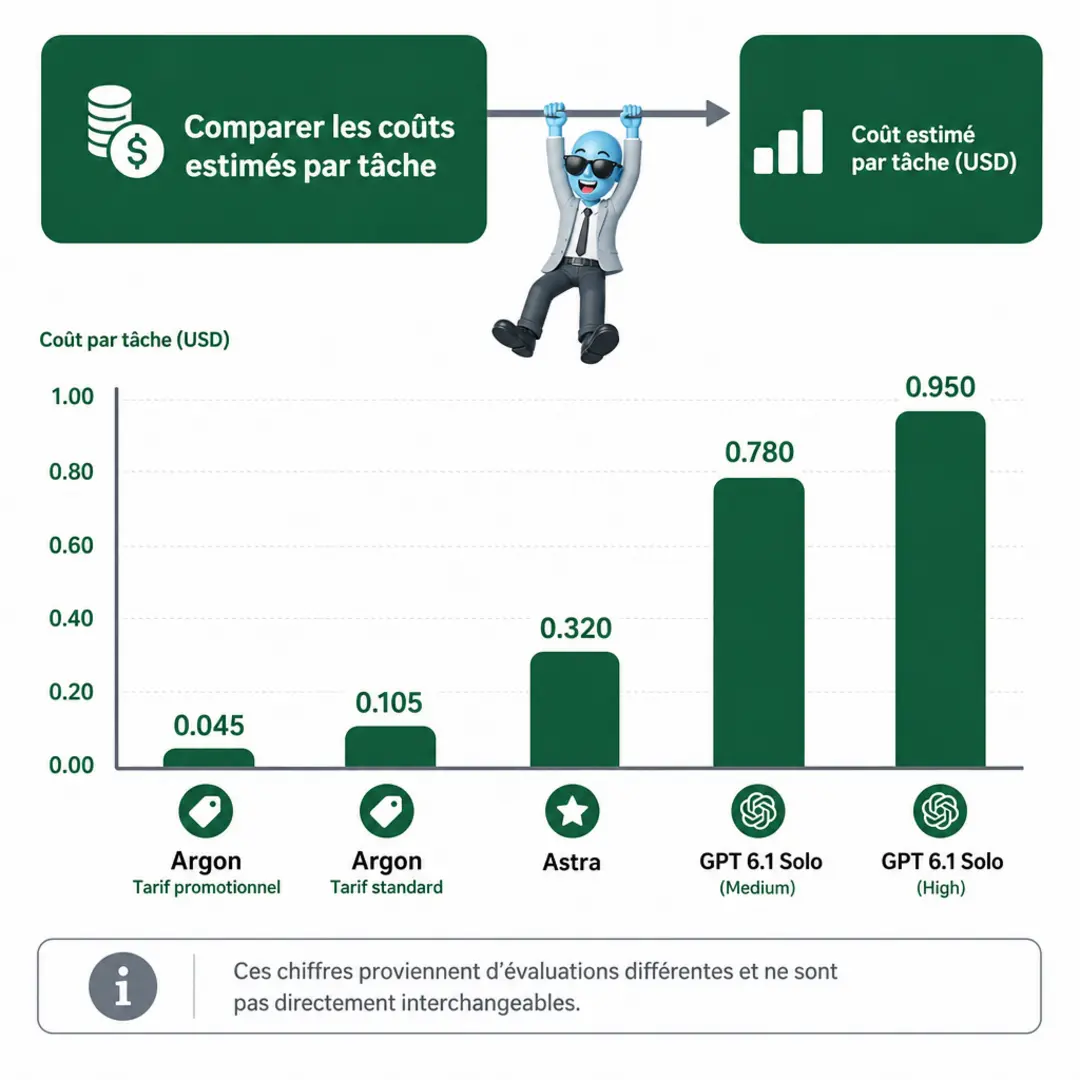
| Modèle | Coût estimé par tâche | Contexte |
| Argon | 1,99 $ | Tarif promotionnel |
| Argon | 3,98 $ | Tarif standard |
| Astra | 3,26 $ | Estimation Artificial Analysis |
| GPT 6.1 Solo | 0,72 $ | Score légèrement inférieur |
Au tarif standard, l’estimation d’Argon atteint donc environ 3,98 $ par tâche. Son avantage tarifaire face à Astra disparaît dans cette comparaison, tandis que GPT 6.1 Solo reste nettement moins cher pour un résultat un peu inférieur. Le coût seul ne suffit toutefois pas à établir un classement global : il faut aussi regarder la qualité obtenue sur la tâche concernée.
Le Vals index donne une autre lecture. Il estime Argon à 15,68 $ par test, un coût inférieur à celui de Sonnet 5.5 et d’Opus 5.5. Cet indice pondère fortement les tâches financières. Un modèle performant sur ces tâches peut donc obtenir un résultat différent de celui observé sur un benchmark généraliste.
Ces montants ne sont pas directement interchangeables. Artificial Analysis et le Vals index n’évaluent pas nécessairement les mêmes tâches, ni selon les mêmes pondérations ou unités de mesure. La conclusion dépend donc du scénario retenu : Argon peut être compétitif sur un indice et plus cher sur un autre. Pour comparer utilement les modèles, je regarderais le coût par résultat exploitable sur vos propres tâches, pas seulement le prix moyen affiché par un benchmark.
Pourquoi le volume de sortie change-t-il le coût ?
Non. Le tarif par token ne donne pas le coût complet si Gemini 4 Argon génère beaucoup plus de tokens que ses concurrents. Dans une évaluation, Argon a produit environ 62 000 tokens de sortie par tâche, contre environ 27 000 pour Astra.
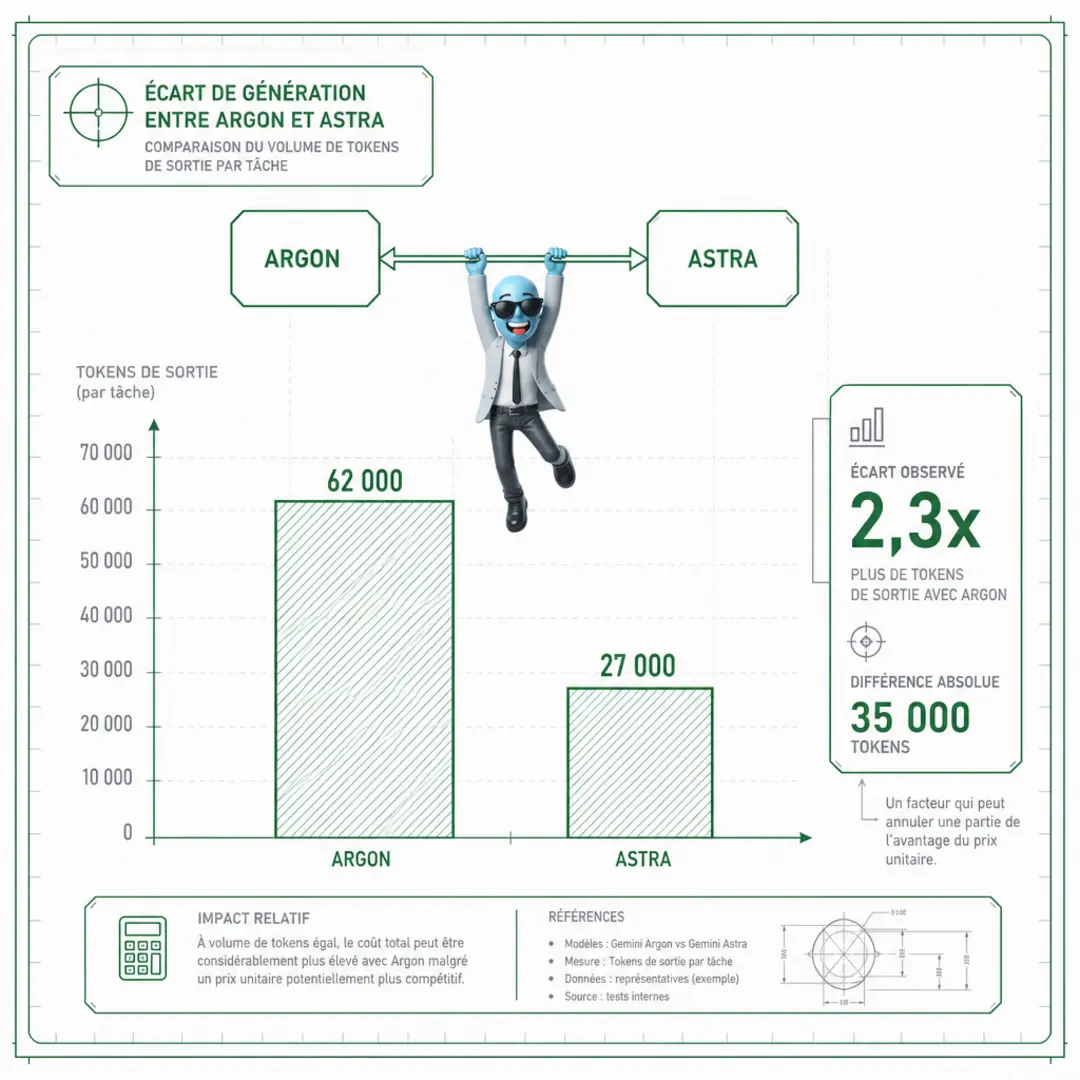
Cet écart peut réduire une partie de l’avantage d’un prix unitaire inférieur. Les tokens de sortie sont facturés séparément et coûtent plus cher que les tokens d’entrée. Une comparaison fondée uniquement sur le tarif affiché par million de tokens sous-estime donc le coût réel lorsque les réponses sont longues.
| Modèle | Tokens de sortie observés par tâche |
| Gemini 4 Argon | Environ 62 000 |
| Astra | Environ 27 000 |
Ces chiffres viennent d’une évaluation précise. Ils ne garantissent pas le même volume sur vos propres tâches : la longueur dépend notamment du prompt, du niveau de détail demandé et du travail attendu du modèle. Pour estimer le coût, il faut comparer des requêtes représentatives de votre usage, pas seulement les prix unitaires.
La limite de sortie annoncée pour Argon atteint un million de tokens. Une méthode de continuation est également mentionnée pour les réponses longues, mais son fonctionnement n’est pas précisé ici. Je ne peux donc pas en déduire comment elle gère la génération, ni quel effet elle a sur le coût.
Pour établir une estimation exploitable, j’intègre quatre variables :
- Le volume de tokens d’entrée, c’est-à-dire le contenu transmis au modèle.
- Le volume de tokens de sortie, qui dépend de la longueur générée.
- Le cache d’entrée, lorsqu’il s’applique aux requêtes répétées.
- Le tarif applicable à chaque catégorie de tokens et au modèle utilisé.
Comment établir un budget réaliste pour Argon ?
Pour éviter de dépendre d’un tarif temporaire, j’établirais le budget sur le tarif standard annoncé : 4 $ par million de tokens en entrée et 20 $ par million en sortie. C’est la base prudente pour estimer le coût réel d’Argon, même si une offre promotionnelle réduit ponctuellement la facture.
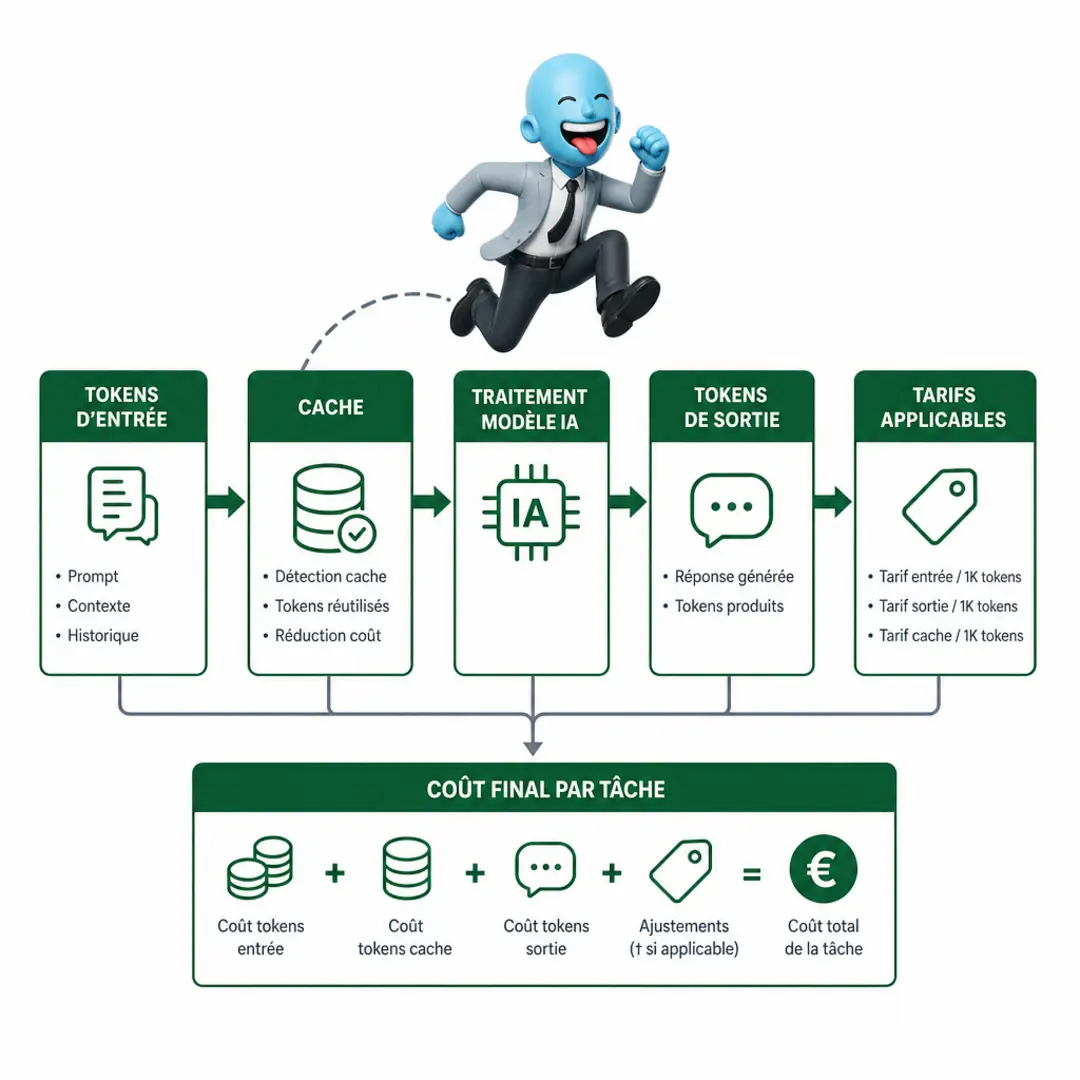
Le coût par tâche dépend du volume de tokens consommé, surtout en sortie. Dans l’évaluation citée, une tâche peut générer environ 62 000 tokens de sortie. Au tarif standard, cela représente à lui seul environ 1,24 $, hors tokens d’entrée. Une estimation sérieuse doit donc s’appuyer sur les volumes observés dans vos propres tâches, et pas seulement sur le prix affiché par million de tokens.
Les résultats varient aussi selon le type d’évaluation. Sur les usages financiers, le Vals index — un indice de performance sur des tâches financières — donne des résultats favorables à Argon. Les évaluations de codage sont plus mitigées. Le coût estimé par tâche et la performance obtenue doivent donc être comparés dans votre contexte : un modèle moins cher par token n’est pas nécessairement moins coûteux pour produire un résultat exploitable.
Je ne conclurais pas qu’Argon est systématiquement moins cher que ses concurrents. Je budgéterais au tarif standard, puis je suivrais séparément les tokens d’entrée, les tokens de sortie et le coût par tâche sur les usages financiers et de codage.
| Critère | Donnée disponible | Implication budgétaire |
| Tarif standard | 4 $ par million de tokens en entrée ; 20 $ en sortie | Utiliser ces tarifs comme base, sans compter sur une offre temporaire |
| Volume de sortie | Jusqu’à environ 62 000 tokens par tâche dans l’évaluation citée | Environ 1,24 $ pour la sortie seule, hors tokens d’entrée |
| Usages financiers | Résultats favorables à Argon selon le Vals index | Évaluer le coût par tâche sur vos cas financiers |
| Codage | Résultats mitigés | Ne pas généraliser le coût ni la performance à tous les usages |
Quel coût devez-vous retenir pour Argon ?
Gemini 4 Argon n’est pas systématiquement moins cher que ses concurrents. Son tarif promotionnel de 2 $ en entrée et 10 $ en sortie par million de tokens peut être attractif, mais il doit doubler selon Google, sans date de fin précisée. Les comparaisons par tâche varient selon l’indice : les résultats sont favorables à Argon sur certaines évaluations financières, tandis que le codage donne des résultats mitigés. Son volume élevé de tokens générés réduit aussi l’avantage du prix unitaire. Pour budgéter, retenez le tarif standard et estimez les tokens réellement consommés. Vous éviterez ainsi une comparaison trompeuse et disposerez d’une base plus fiable pour arbitrer vos coûts d’IA.
FAQ
- Quel est le tarif promotionnel de Gemini 4 Argon ?
Le tarif de lancement est de 2 $ par million de tokens en entrée et de 10 $ par million en sortie. Les entrées mises en cache bénéficient d’une réduction de 95 %. - Quel tarif faut-il utiliser pour budgéter Argon ?
Google indique que les tarifs doivent doubler après la période promotionnelle, dont la date de fin n’est pas précisée. Pour planifier, retenez 4 $ par million de tokens en entrée et 20 $ en sortie. - Argon est-il moins cher qu’Astra ?
Dans l’estimation d’Artificial Analysis, Argon coûte environ 1,99 $ par tâche au tarif promotionnel, contre environ 3,26 $ pour Astra. Le coût dépend toutefois de l’évaluation et peut atteindre environ 3,98 $ par tâche au tarif standard. - Pourquoi les tokens de sortie pèsent-ils autant dans la facture ?
Les tokens de sortie ont un tarif distinct et Argon en génère environ 62 000 par tâche dans une évaluation citée, contre environ 27 000 pour Astra. Ce volume peut réduire l’avantage du prix par token. - Argon est-il performant pour le codage ?
Les évaluations de codage sont mitigées. Les résultats favorables observés sur certaines tâches financières ne permettent donc pas de conclure qu’Argon est le meilleur choix pour tous les usages.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. J’analyse les coûts d’usage des modèles et leur impact sur la performance des applications métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.